 Proxmox VE — TSSR
6. Haute disponibilité (HA)
La migration à chaud du §2 répond à une maintenance prévue : l'administrateur choisit le moment, la VM part pendant qu'elle tourne. La haute disponibilité répond à ce qu'on ne choisit pas : un nœud qui s'éteint, une carte mère qui lâche, un service qui refuse de démarrer.
Dans ces cas, Proxmox VE décide seul de relancer les machines concernées ailleurs, sans intervention humaine. Cette section décrit précisément comment il prend cette décision, ce qu'il lui faut pour la prendre sans risque, et comment l'administrateur garde la main.
6.1 Ce que « haute disponibilité » veut dire
La haute disponibilité désigne la capacité d'un service à rester accessible malgré la défaillance d'un ou plusieurs composants de l'infrastructure. Elle se mesure en pourcentage de temps de fonctionnement sur une année. Le guide d'administration de Proxmox VE donne la correspondance suivante :
| Disponibilité | Temps d'arrêt annuel |
|---|---|
| 99 % | 3,65 jours |
| 99,9 % | 8,76 heures |
| 99,99 % | 52,56 minutes |
| 99,999 % | 5,26 minutes |
| 99,9999 % | 31,5 secondes |
| 99,99999 % | 3,15 secondes |
Proxmox VE intègre un gestionnaire de haute disponibilité, ha-manager. Il détecte la panne d'un nœud et redémarre les VM et conteneurs qu'il protège sur un autre nœud du cluster.
La documentation officielle donne un ordre de grandeur honnête : environ 2 minutes entre la panne et le redémarrage du service. Une seule panne par an consomme donc déjà l'essentiel du budget de 99,999 % — c'est le plafond atteignable avec ce mécanisme.
La HA n'est pas de la continuité sans coupure. Sur une panne de nœud, la VM redémarre ailleurs, à froid : ce qui était en mémoire est perdu, les connexions ouvertes sont coupées. Seule une maintenance planifiée (§7.1) déplace les VM à chaud, sans interruption.
6.2 Les prérequis
Quatre conditions doivent être réunies avant d'activer la HA. Les trois premières sont indispensables.
| Prérequis | Pourquoi |
|---|---|
| Au moins 3 nœuds | Le quorum Corosync exige une majorité absolue (§1.1). Avec deux nœuds, la perte de l'un laisse l'autre minoritaire : il ne peut plus rien décider, donc plus rien relancer. |
| Un stockage partagé | Relancer une VM sur un autre nœud suppose que ce nœud voie son disque : Ceph, NFS ou iSCSI. Sur un stockage local, le disque est resté sur la machine tombée. |
| De la redondance matérielle | Alimentations et liens réseau doublés, mémoire ECC (Error-Correcting Code, qui corrige les erreurs de bits). La HA logicielle relance les services ; elle ne compense pas un matériel qui tombe en cascade. |
| Un watchdog | Il garantit qu'un nœud isolé s'arrête vraiment avant qu'on relance ses VM ailleurs (§6.4). Proxmox utilise par défaut le watchdog logiciel du noyau, softdog. |
La HA exige un stockage partagé. C'est Ceph, déployé aux sections 3 à 5, qui le fournit : la VM que l'atelier 6 fait basculer est celle que vous avez posée sur le pool Ceph (§4).
La HA repose sur deux démons, le CRM (Cluster Resource Manager) et le LRM (Local Resource Manager).
6.3 Fonctionnement interne : le CRM décide, le LRM exécute
Deux démons tournent en permanence sur chaque nœud du cluster.
| Démon | Nom complet | Rôle |
|---|---|---|
pve-ha-crm |
Cluster Resource Manager | Prend les décisions pour tout le cluster : surveille l'état des nœuds, détecte les pannes, choisit où relancer. Un seul CRM est maître à un instant donné ; les autres sont en veille. |
pve-ha-lrm |
Local Resource Manager | Exécute localement les ordres du CRM : démarrer, arrêter, migrer une VM ou un conteneur de son nœud, puis remonter le résultat. |
L'unicité du maître ne repose pas sur une élection réseau, mais sur des verrous du système de fichiers de cluster pmxcfs (/etc/pve). Le CRM qui détient le verrou ha_manager_lock est le maître ; chaque LRM actif détient le verrou de son nœud, ha_agent_<nœud>_lock. Ces verrous sont visibles dans /etc/pve/priv/lock/.
Dans le Shell du nœud :
# Les verrous HA, dans le système de fichiers du cluster
ls /etc/pve/priv/lock/
Résultat attendu (cluster de l'atelier 6, VM 300 sous HA) :
ha_agent_pxe211_lock
ha_agent_pxe212_lock
ha_manager_lock
Ces verrous garantissent qu'un seul CRM décide et qu'un seul LRM agit par nœud. Ils sont aussi la clé du fencing. Si le maître tombe, un autre CRM acquiert ha_manager_lock et prend la relève.
Si un nœud tombe, c'est la prise de son verrou d'agent par le CRM qui l'autorise à voler ses services. Le journal du CRM montre cette prise de fonction au démarrage.
Dans le Shell du nœud :
# Journal du CRM (extrait)
journalctl -u pve-ha-crm
Résultat attendu (pxe213, devenu maître au redémarrage du cluster) :
pve-ha-crm[1412]: successfully acquired lock 'ha_manager_lock'
pve-ha-crm[1412]: watchdog active
pve-ha-crm[1412]: status change slave => master
ha-manager status résume l'ensemble. Sortie du lab, la VM 300 de l'atelier 6 placée sous HA.
Dans le Shell du nœud :
# Résumé de la HA : quorum, maître, LRM, ressources
ha-manager status
quorum OK
master pxe213 (active, Wed Oct  7 18:13:02 2026)
fencing armed (CRM watchdog active)
lrm pxe211 (active, watchdog active, Wed Oct  7 18:13:07 2026)
lrm pxe212 (idle, watchdog standby, Wed Oct  7 18:13:09 2026)
lrm pxe213 (idle, watchdog standby, Wed Oct  7 18:13:08 2026)
service vm:300 (pxe211, started)
| Ligne | Lecture |
|---|---|
quorum OK |
Le nœud interrogé fait partie de la partition majoritaire : les décisions HA sont possibles. |
master pxe213 (active, …) |
Le CRM maître, et l'heure de son dernier signe de vie. |
fencing armed (CRM watchdog active) |
Un maître gère au moins une ressource : son watchdog est armé. |
lrm … (active, watchdog active, …) |
Le LRM a pris son verrou et arme son watchdog : le nœud a (ou a eu récemment) une ressource HA. |
lrm … (idle, watchdog standby, …) |
Le LRM n'a aucune ressource HA à gérer : pas de watchdog armé. |
service vm:300 (pxe211, started) |
La ressource, le nœud qui l'héberge, son état courant (§6.6). |
La ligne fencing est apparue avec Proxmox VE 9.2. Sans ressource HA, elle vaut fencing standby (CRM watchdog standby) : aucun CRM ne gère activement de service. Elle passe à armed dès qu'un maître prend en charge une ressource, comme ci-dessus.
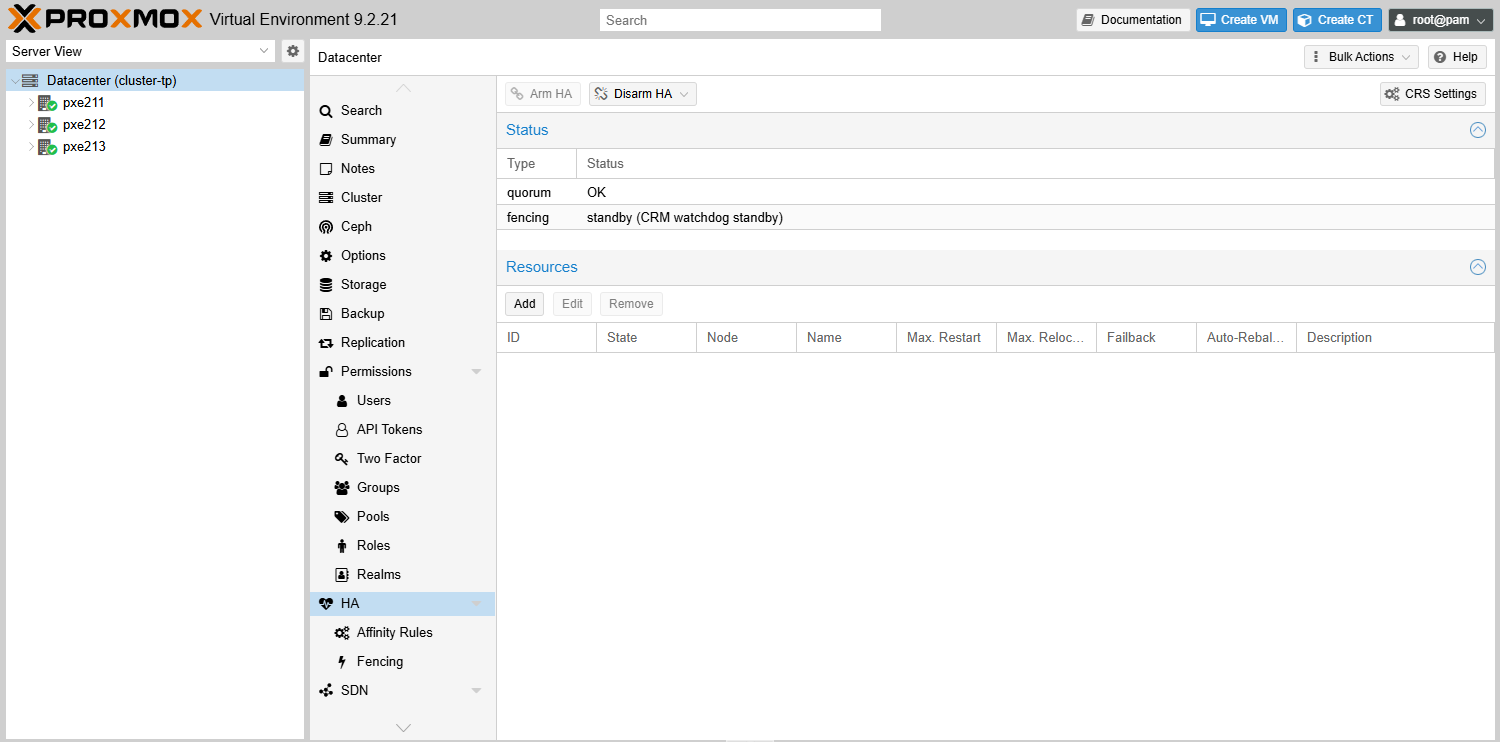
La même chose dans Datacenter → HA, sur le cluster du lab avant l'atelier 6 : quorum OK, puis fencing standby (CRM watchdog standby), car aucune ressource n'est encore sous HA (la liste Resources est vide). Le bouton Add de cette liste est celui du § 6.5.
6.4 Le fencing et le watchdog
Le fencing (« mise à l'écart ») est le mécanisme qui isole définitivement un nœud défaillant avant de relancer ses services ailleurs. Il existe pour empêcher le pire scénario d'un cluster : deux instances de la même VM qui écrivent en même temps sur le même disque partagé. Le résultat est une corruption garantie du système de fichiers de la VM.
Le cas difficile n'est pas le nœud mort, mais le nœud à moitié vivant. Il ne répond plus sur le réseau du cluster : Corosync ne le voit plus. Mais son processeur tourne toujours, et ses VM aussi.
Le CRM voudrait relancer ces VM ailleurs ; s'il le fait alors que le nœud continue d'écrire sur Ceph, c'est le split-brain. Ce nœud ne peut pas libérer son verrou lui-même, et personne ne peut lui demander de s'arrêter : il n'est plus joignable.
C'est le rôle du watchdog, un minuteur que le nœud doit réarmer régulièrement faute de quoi il redémarre de force. Le guide d'administration le décrit ainsi. Un nœud qui constate qu'il n'est plus dans la partition quorate ne peut plus réarmer son watchdog.
S'il héberge des services actifs, le watchdog expire et redémarre le nœud au bout de 60 secondes. Le CRM, de son côté, sait qu'au-delà de ce délai le nœud isolé est forcément arrêté : il peut prendre son verrou et relancer ses services sans risque.
La séquence, dans l'ordre :
- Le nœud est isolé : réseau du cluster coupé, processeur toujours actif.
- Hors quorum, son LRM ne peut plus réarmer le watchdog.
- Le watchdog expire au bout de 60 secondes : le nœud redémarre de force.
- Le CRM acquiert le verrou du nœud : ses services passent en
recovery. - Les VM redémarrent sur un nœud sain.
Sur le lab, pendant l'atelier 6, ces étapes se lisaient dans le journal du nouveau maître : fencing: acknowledged - got agent lock for node 'pxe212', puis recover service 'vm:300' from fenced node 'pxe212' to node 'pxe213'.
Deux familles de watchdog existent :
softdog (logiciel, par défaut) |
Watchdog matériel (IPMI, iDRAC, iTCO…) | |
|---|---|---|
| Disponible sans configuration | Oui | Non : module à déclarer |
| Résiste à un kernel panic | Non | Oui |
| Résiste à un gel complet du processeur | Non | Oui |
| Usage | Laboratoire, infrastructure non critique | Production avec stockage partagé |
softdog tourne dans le noyau qu'il surveille : si ce noyau est figé, il ne peut plus rien déclencher. Un watchdog matériel est un circuit indépendant de la carte mère, qui coupe le serveur quoi qu'il arrive au système. Tous les modules de watchdog matériel sont bloqués par défaut, car un watchdog mal initialisé peut redémarrer un serveur sain.
Pour en activer un, on déclare son module dans /etc/default/pve-ha-manager, lu par le service watchdog-mux. Le fichier livré avec Proxmox VE 9.2 contient ceci.
Dans le Shell du nœud :
# Le fichier lu par watchdog-mux
cat /etc/default/pve-ha-manager
# select watchdog module (default is softdog)
#WATCHDOG_MODULE=ipmi_watchdog
Ne jamais arrêter pve-ha-crm, pve-ha-lrm ou watchdog-mux à la main sur un nœud qui héberge des ressources HA. Ces services tiennent le watchdog ouvert : les tuer revient à cesser de le réarmer, et le nœud redémarre brutalement. Le guide d'administration le signale explicitement.
Le mode de fencing du cluster se règle dans datacenter.cfg (fencing: watchdog, valeur par défaut). Les valeurs hardware et both pilotent des équipements de coupure externes, décrits dans /etc/pve/ha/fence.cfg. La documentation de la version 9.2 les marque expérimentales : on s'en tient au watchdog.
Revenons à la définition de base : la haute disponibilité relance un service ailleurs quand son serveur tombe, sans intervention humaine. Le danger est de le relancer alors que l'original tourne encore. Les composants du mécanisme :
| Terme | Ce que c'est | Dans le laboratoire |
|---|---|---|
| Ressource HA | Une VM ou un conteneur placé sous la surveillance du gestionnaire HA | vm:300 (vm-ha-test) |
| CRM | pve-ha-crm : décide pour tout le cluster ; un maître, les autres en veille |
La ligne master de ha-manager status |
| LRM | pve-ha-lrm : exécute sur son nœud les ordres du CRM |
Une ligne lrm par nœud |
| Verrou | Un verrou de /etc/pve : ha_manager_lock pour le maître, ha_agent_<nœud>_lock pour chaque LRM |
/etc/pve/priv/lock/ |
| Watchdog | Un minuteur que le nœud réarme ; hors quorum, il ne peut plus, et le nœud redémarre au bout de 60 secondes | softdog, par défaut |
| Fencing | Mettre le nœud défaillant hors jeu avant de relancer ses services | fencing: acknowledged - got agent lock for node 'pxe212' |
| Recovery | La relance des services sur un nœud sain | recover service 'vm:300' … to node 'pxe213' |
| Watchdog matériel | Un circuit de la carte mère, qui coupe même un système figé | Non utilisé au laboratoire |
Le cas délicat est le nœud coupé du réseau du cluster, dont les VM tournent toujours. Le CRM attend que le watchdog ait redémarré ce nœud, puis prend son verrou d'agent : seulement alors, il relance ses services sur un nœud sain.
Où voir la haute disponibilité sur votre cluster :
| Notion | Où la voir |
|---|---|
| Le maître, les LRM, les ressources | Datacenter → HA ; ha-manager status |
| Les verrous | ls /etc/pve/priv/lock/ |
| Les décisions du CRM (fencing, recovery) | journalctl -u pve-ha-crm sur le nœud maître |
| Le watchdog | /etc/default/pve-ha-manager (module), service watchdog-mux |
| Le mode de fencing | /etc/pve/datacenter.cfg (fencing: watchdog par défaut) |
6.5 Les ressources HA
Une ressource HA est une VM ou un conteneur confié au ha-manager. Elle est identifiée par un SID (Service ID) de la forme type:id : vm:100 pour la VM 100, ct:200 pour le conteneur 200. Les ressources sont stockées dans /etc/pve/ha/resources.cfg, répliqué sur tous les nœuds par pmxcfs.
Activer la HA pour une VM — via l'interface graphique :
Datacenter → HA → Resources → Add
| Champ | Valeur |
|---|---|
| VM | 300 (sur Ceph, atelier 5, placée sous HA à l'atelier 6) |
| Max. Restart | 1 |
| Max. Relocate | 1 |
| Request State | started |
Équivalent CLI :
Dans le Shell du nœud (interface web → votre nœud → Shell) :
# Placer la VM 300 sous la protection de la HA : "started" = toujours la maintenir démarrée
ha-manager add vm:300 --state started --max_restart 1 --max_relocate 1
Après ha-manager add vm:950 --state started --max_restart 1 --max_relocate 1 sur le cluster d'exemple, le fichier contient exactement :
vm: 950
    max_relocate 1
    max_restart 1
    state started
Les propriétés d'une ressource, telles que les décrit ha-manager help add sur Proxmox VE 9.2 :
| Propriété | Rôle | Défaut |
|---|---|---|
state |
État demandé : started, stopped, disabled, ignored (enabled est un alias de started) |
started |
max_restart |
Nombre de nouvelles tentatives de démarrage sur le même nœud après un échec | 1 |
max_relocate |
Nombre de déplacements vers un autre nœud après échec des redémarrages | 1 |
failback |
Ramener automatiquement la ressource sur le nœud de plus haute priorité de sa règle d'affinité quand il revient | 1 (activé) |
auto-rebalance |
Autoriser la ressource à être déplacée par le rééquilibrage automatique | 1 |
comment |
Description libre | — |
group |
Ancien groupe HA — déprécié au profit des règles d'affinité | — |
:::tip
Une ressource HA se pilote comme une VM ordinaire. Les commandes qm start et qm stop, comme les boutons de l'interface, sont transmises au gestionnaire HA quand la VM en est une ressource. Sur le cluster d'exemple, qm start 950 répond simplement Requesting HA start for VM 950 : c'est le CRM qui décide ensuite du nœud et lance le démarrage.
:::
6.6 Les états d'une ressource
Le CRM tient pour chaque ressource un état courant, distinct de l'état demandé. C'est lui qu'affichent ha-manager status et Datacenter → HA. La liste est celle du guide d'administration :
| État | Signification |
|---|---|
queued |
Ressource tout juste ajoutée, que le CRM n'a pas encore vue |
started |
Active : le LRM la démarre si elle ne tourne pas, la redémarre si elle s'arrête |
starting |
Démarrage demandé, le CRM attend la confirmation du LRM |
request_stop |
Arrêt demandé, le CRM attend la confirmation du LRM |
stopping |
Arrêt en attente, pas encore transmis |
stopped |
Arrêtée, confirmé par le LRM ; si elle redémarre seule, le LRM l'arrête de nouveau |
migrate |
Migration à chaud en cours vers un autre nœud |
fence |
Le nœud hôte est hors de la partition quorate : attente de son fencing |
recovery |
Nœud isolé avec succès : recherche d'un nouveau nœud |
freeze |
Ne pas toucher : nœud en cours de redémarrage ou LRM en cours de mise à jour |
ignored |
Traitée comme si elle n'était pas sous HA, sans la retirer de la configuration |
error |
Échec de la politique de récupération : intervention manuelle requise |
disabled |
Arrêtée et désactivée |
Un état supplémentaire, deleting, apparaît brièvement quand une ressource est retirée par ha-manager remove, service vm:950 (pxe213, deleting), affiché pendant plusieurs secondes.
6.7 Commandes et fichiers à connaître
| Action | Commande |
|---|---|
| Placer une VM sous HA | ha-manager add vm:300 --state started |
| Changer l'état demandé | ha-manager set vm:300 --state stopped |
| Lister les ressources | ha-manager config |
| État global | ha-manager status (--verbose 1 pour le détail JSON) |
| Migrer à chaud, VM démarrée | ha-manager crm-command migrate vm:300 pxe212 (alias : ha-manager migrate) |
| Déplacer par arrêt puis redémarrage | ha-manager crm-command relocate vm:300 pxe212 (alias : ha-manager relocate) |
| Gérer les règles | ha-manager rules add / list / set / remove |
| Sortir une ressource de la HA | ha-manager remove vm:300 |
| Suivre les décisions | journalctl -u pve-ha-crm -f (maître) et journalctl -u pve-ha-lrm -f (chaque nœud) |
| Fichier | Contenu |
|---|---|
/etc/pve/ha/resources.cfg |
Les ressources HA et leurs propriétés |
/etc/pve/ha/rules.cfg |
Les règles d'affinité (Proxmox VE 9) |
/etc/pve/ha/groups.cfg |
Les anciens groupes (version 8, convertis à la mise à niveau) |
/etc/pve/ha/manager_status |
L'état courant tenu par le CRM, lu par les LRM |
/etc/pve/nodes/<nœud>/lrm_status |
Ce que chaque LRM remonte au CRM |
/etc/default/pve-ha-manager |
Le module de watchdog à charger |
Points clés à retenir. La HA exige au moins trois nœuds, un stockage partagé et un watchdog. Le CRM décide, le LRM exécute ; les verrous de pmxcfs garantissent un seul maître.
Le fencing, par le watchdog, isole un nœud avant de relancer ses services — compter environ 2 minutes. Une ressource qui échoue partout passe en error et attend l'administrateur : disabled, corriger, started. Depuis Proxmox VE 9, les groupes sont remplacés par les règles d'affinité.
- 📖 Documentation Proxmox — High Availability
- 📖 Les règles HA dans le guide d'administration
- 📖 Options du fichier datacenter.cfg (CRS — Cluster Resource Scheduling —, fencing, politique d'arrêt)
- 🎥 Simulation de panne d'un nœud et basculement automatique des VM HA (vidéo)
▶ À pratiquer maintenant — Atelier 6
Inscrire la VM 300, posée sur Ceph, comme ressource HA, couper brutalement son nœud, et chronométrer le cluster qui la relance ailleurs. Puis mettre un nœud en maintenance et voir la VM partir et revenir à chaud.