 Proxmox VE — TSSR
3. Ceph : architecture et déploiement
Imaginez un système de stockage sans point de défaillance unique. Il distribue automatiquement les données sur plusieurs disques et plusieurs serveurs.
Il se répare tout seul en cas de panne, et s'intègre directement dans votre hyperviseur. C'est exactement ce que fait Ceph.
Ceph est né de la thèse de doctorat de Sage Weil à l'université de Californie à Santa Cruz (UC : University of California) en 2007. Son idée centrale : un algorithme de placement de données appelé CRUSH (Controlled Replication Under Scalable Hashing).
N'importe quel client calcule lui-même où se trouvent ses données, sans passer par un serveur de métadonnées centralisé. Cette approche élimine les goulots d'étranglement et les points uniques de défaillance.
Proxmox VE intègre Ceph depuis la version 3.2 (2014), et le pilote entièrement depuis son interface depuis la version 5. En quelques clics dans l'interface (ou quelques commandes), vous transformez les disques locaux de vos nœuds en un stockage distribué partagé, accessible par l'ensemble du cluster.
- 🎥 Ceph, le stockage du futur — conférence du Capitole du Libre : la conférence présentée au chapitre 3 (§5.3), à revoir pour les principes de distribution, de réplication et l'algorithme CRUSH.
3.1 Architecture Ceph — les composants
Avant de déployer Ceph, il est essentiel de comprendre le rôle de chaque composant, car chacun a une responsabilité précise dans le fonctionnement du cluster :
MON — Monitor : Le MON maintient la "carte" du cluster Ceph — il sait où sont tous les OSDs, leur état de santé, et la topologie de réplication. Sans MON, rien ne fonctionne.
Comme pour Corosync, le quorum des MONs est indispensable : il faut toujours un nombre impair de MONs, avec un minimum de 3 en production. Dans notre atelier, 1 MON par nœud, soit 3 au total.
MGR — Manager : Le MGR collecte les statistiques du cluster (utilisation, IOPS, latence) et expose le dashboard web de Ceph. Les entrées/sorties continuent sans lui pendant un court moment. Mais Ceph le considère comme un service requis depuis Luminous.
Sans manager : plus de statistiques de placement, plus d'autoscaler, plus de balancer, et ceph status se dégrade. On en déploie donc un par nœud, comme les moniteurs.
MON et MGR ne fonctionnent pourtant pas de la même façon. Les moniteurs travaillent tous en même temps et votent : c'est leur majorité qui fait autorité sur la carte du cluster, exactement la logique de quorum vue pour Corosync.
Les managers fonctionnent en actif/veille : un seul est actif à un instant donné, les autres attendent et prennent la main automatiquement s'il disparaît. ceph -s le montre directement.
Dans le Shell du nœud :
# État du cluster Ceph (extrait : lignes mon et mgr)
ceph -s
    mon: 3 daemons, quorum pve1,pve2,pve3
    mgr: pve1(active, since 4m), standbys: pve2, pve3
Trois managers ne rendent pas Ceph plus rapide — ils évitent de perdre la supervision le jour où un nœud tombe.
OSD — Object Storage Daemon : C'est le cœur du stockage. Chaque OSD gère un disque physique.
Quand vous écrivez une donnée, Ceph la découpe en objets et les répartit sur plusieurs OSDs selon les règles de réplication définies dans votre pool. Si un OSD tombe, les autres prennent le relais automatiquement et commencent à répliquer les données manquantes.
MDS — Metadata Server : Uniquement nécessaire pour CephFS (le système de fichiers POSIX de Ceph). Pour notre usage (stockage de disques VMs via RBD), les MDS ne sont pas requis.
Revenons à la définition de base : un stockage distribué range les données sur les disques de plusieurs serveurs, et les garde lisibles si l'un d'eux tombe. Ceph se compose de plusieurs services, chacun avec son rôle :
| Terme | Ce que c'est | Dans le laboratoire |
|---|---|---|
| OSD | Un démon par disque : il stocke les objets et réplique vers les autres | Un OSD par nœud, sur /dev/sdb |
| MON | Les moniteurs tiennent la carte du cluster ; leur majorité fait autorité | Trois MON, un par nœud |
| MGR | Supervision, tableau de bord, autoscaler ; actif/veille | Trois MGR, un actif |
| Pool | Un espace logique, avec son nombre de copies | ceph-vm (§4.1) |
size / min_size |
Le nombre de copies, et le minimum pour accepter les écritures | 3 / 2 |
| CRUSH | L'algorithme qui calcule où se trouve chaque objet (§4.2) | Une copie par nœud |
| RBD | Un disque bloc, découpé en objets dans le pool | Les disques des VM sur ceph-vm |
| MDS | Le serveur de métadonnées, requis seulement pour CephFS | Non déployé |
Un nœud qui tombe ne fait perdre aucune donnée : les deux autres ont une copie, et les OSD en recréent une troisième. Aucun serveur central n'est consulté pour trouver un objet : chaque client calcule son emplacement avec CRUSH, ce qui évite le point de défaillance unique.
Où voir Ceph sur votre cluster :
| Notion | Où la voir |
|---|---|
| L'état global | Nœud → Ceph (tableau de bord : HEALTH_OK, MON, OSD) ; ceph -s |
| Les moniteurs et managers | Nœud → Ceph → Monitor ; lignes mon: et mgr: de ceph -s |
| Les OSD et leur disque | Nœud → Ceph → OSD ; ceph osd tree |
Les pools, size et min_size |
Nœud → Ceph → Pools ; Datacenter → Storage : le stockage de type RBD |
3.2 Déployer Ceph depuis Proxmox VE
L'installation de Ceph dans Proxmox se fait idéalement depuis l'interface graphique.
Étape 1 — Installer Ceph (sur chaque nœud) :
Nœud → Ceph → Install Ceph
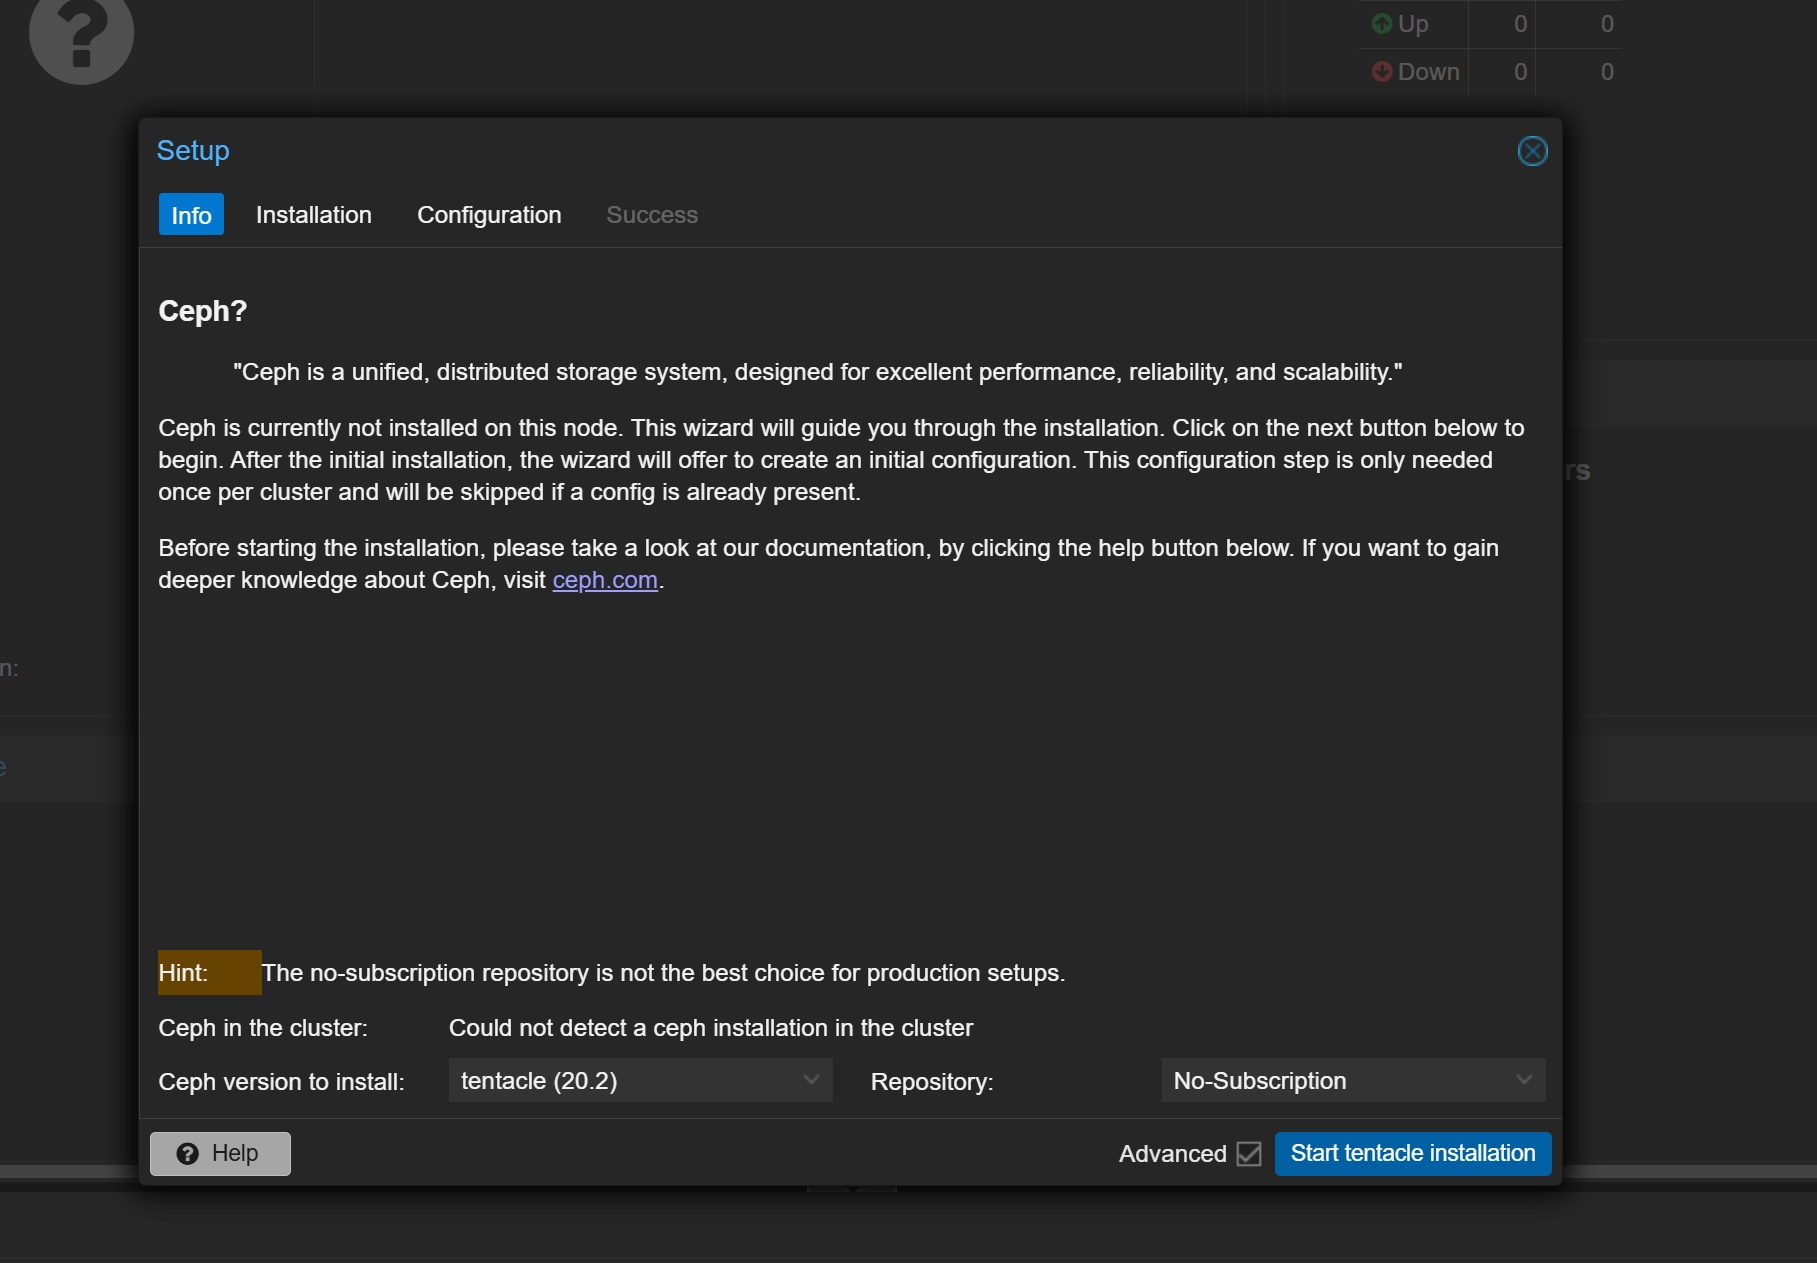
Le premier onglet de l'assistant, avant toute installation. Trois choses à y lire :
- Ceph version to install : la version proposée, ici tentacle (20.2). Prenez celle que Proxmox propose — elle est alignée sur votre version de PVE, et mélanger les versions entre nœuds vous coûterait cher.
- Repository : No-Subscription : le dépôt gratuit, celui que vous avez configuré au début. Le champ existe parce qu'un abonnement donne accès au dépôt Enterprise, plus lentement mis à jour mais davantage testé.
- Ceph in the cluster : Could not detect a ceph installation : normal sur le premier nœud. Sur les deux suivants, cette ligne indiquera au contraire la version déjà présente — c'est votre confirmation que vous installez bien la même.
Le bandeau Hint dit sans détour que le dépôt sans abonnement n'est pas le meilleur choix en production. C'est vrai, et ça n'empêche rien : les paquets sont les mêmes, ils arrivent simplement plus tôt.
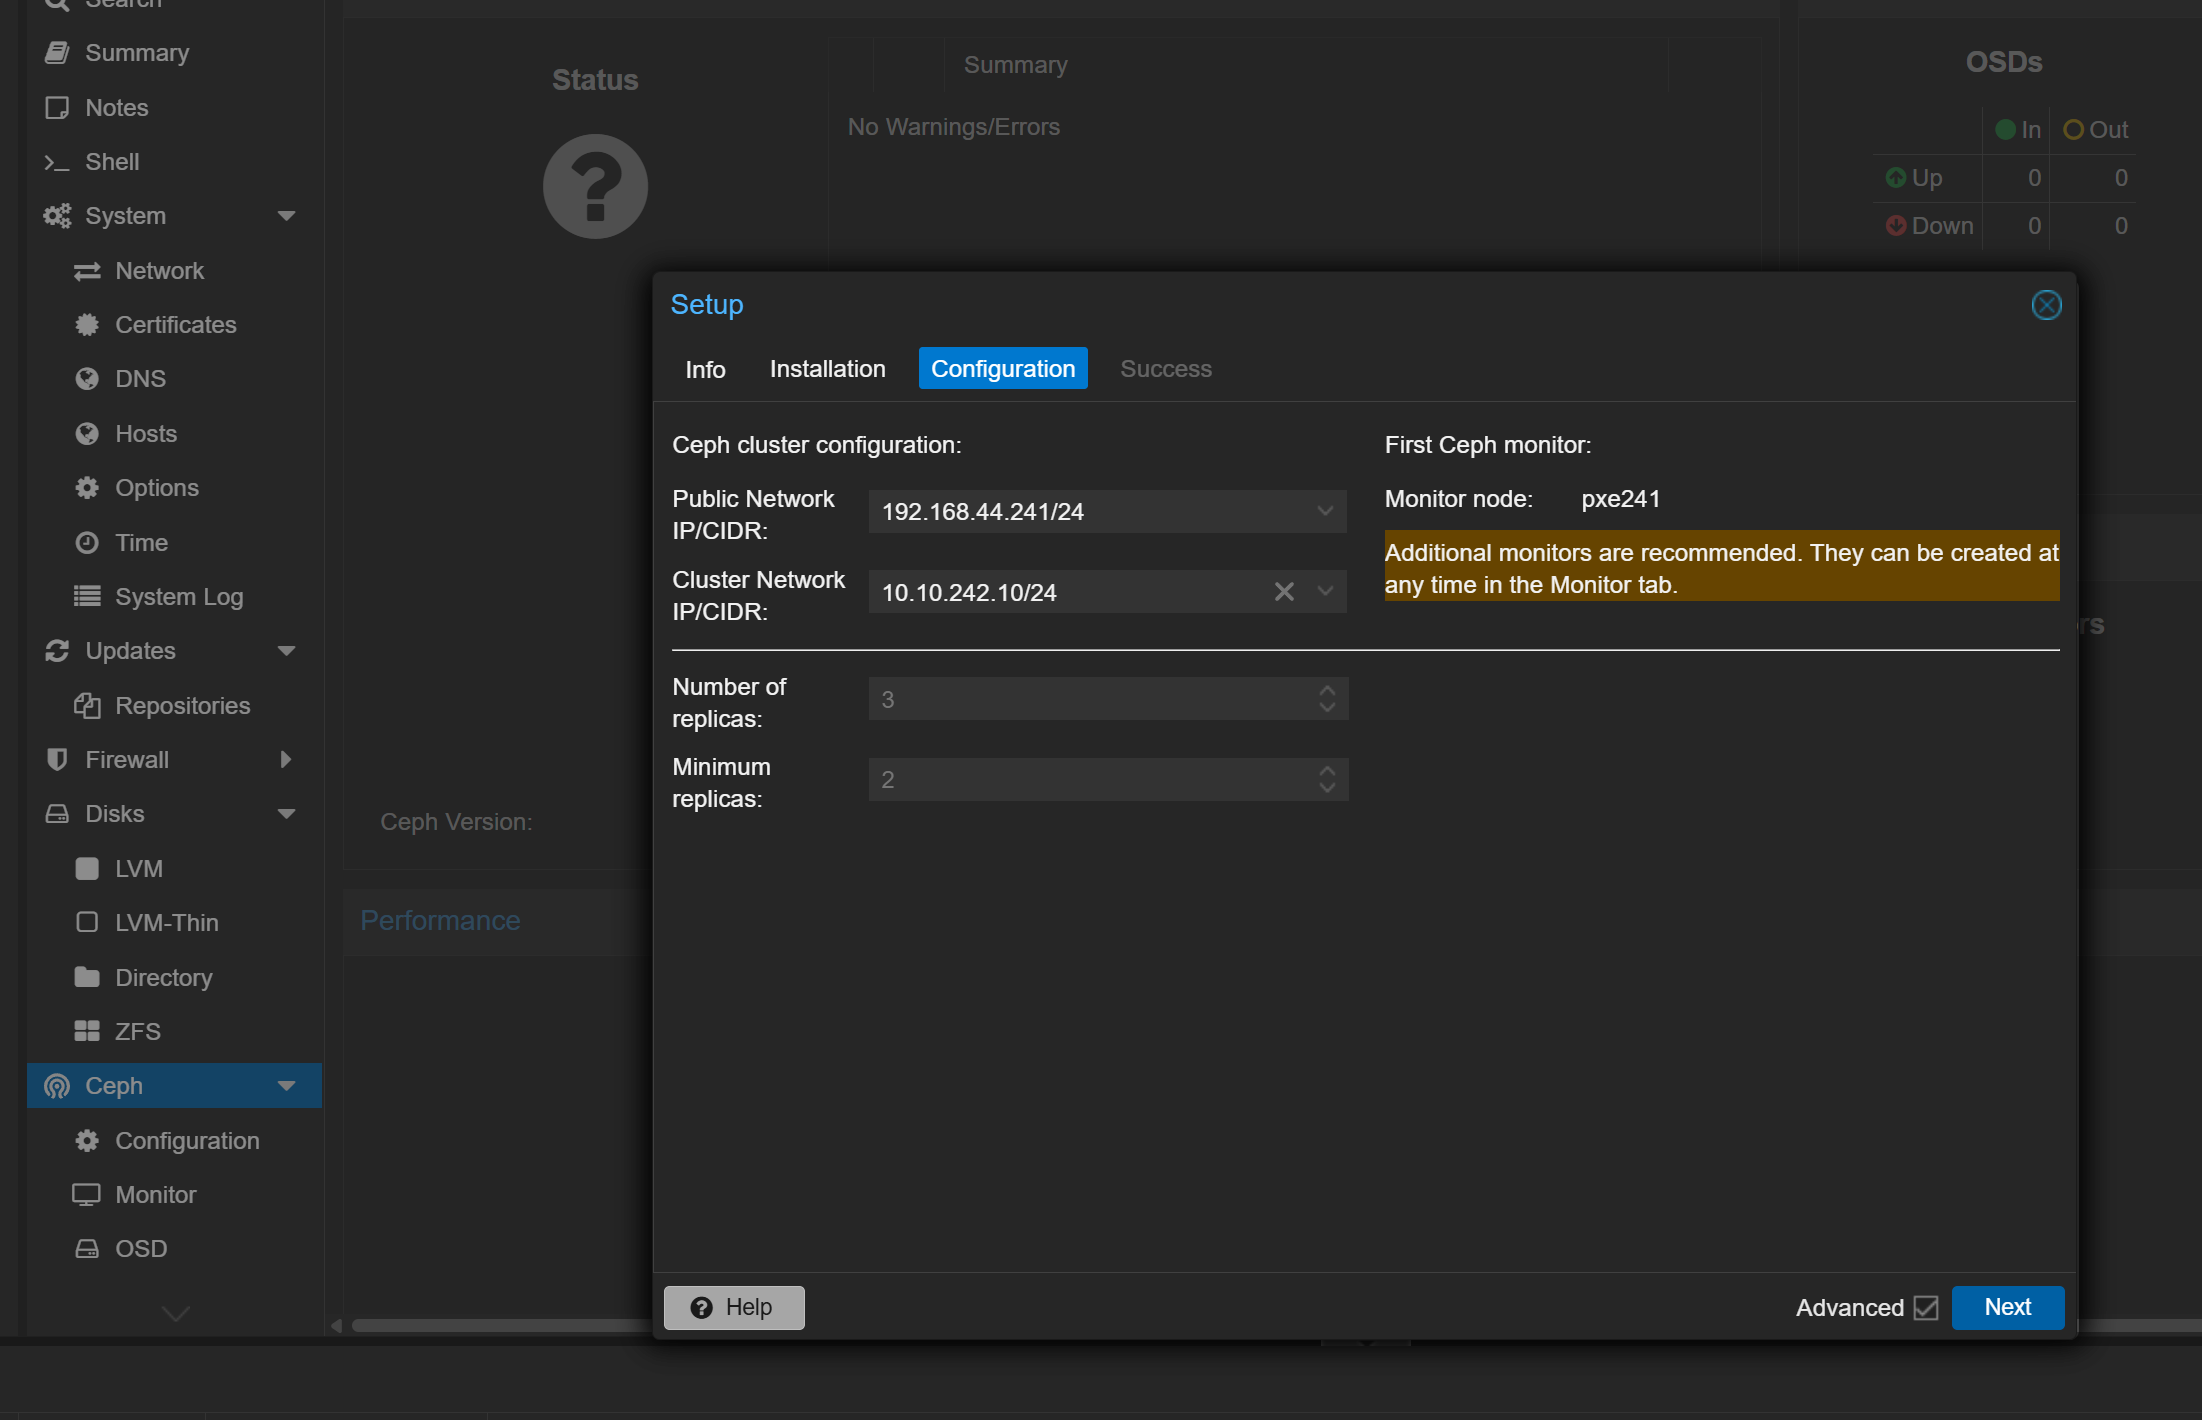
C'est l'écran où tout se joue. L'assistant se déroule en quatre onglets (Info, Installation, Configuration, Success) ; celui-ci est le troisième, et le seul qui demande de vraies décisions.
- Public Network IP/CIDR : le réseau par lequel les clients parlent à Ceph : c'est par là que vos VM liront et écriront leurs disques. Sur le lab, le réseau préparé sur
ens21. - Cluster Network IP/CIDR : le réseau que les OSD utilisent entre eux pour se répliquer. C'est le trafic le plus lourd de Ceph — chaque écriture est recopiée deux fois de plus — et c'est pourquoi on le sépare du réseau public quand on le peut. Sur le lab, le réseau dédié préparé sur
ens20. - Number of replicas : 3 — chaque donnée existe en trois exemplaires, sur trois nœuds différents.
-
Minimum replicas : 2 — le nombre de copies encore disponibles en dessous duquel Ceph refuse d'écrire. C'est la valeur qui vous protège.
Avec 3 et 2, un nœud peut tomber sans que rien ne s'arrête. Si un deuxième tombe, Ceph bloque les écritures plutôt que de risquer une donnée en exemplaire unique.
-
First Ceph monitor : le nœud qui hébergera le premier moniteur. L'encadré jaune le dit clairement : « Additional monitors are recommended ».
Un moniteur seul est un point de défaillance. Vous en ajouterez deux autres à l'étape suivante, pour que la carte du cluster tienne, elle aussi, à la majorité.
Remarquez enfin la colonne de gauche : sous Ceph apparaissent déjà Configuration, Monitor et OSD — les trois endroits où vous reviendrez. Et en haut à droite, le compteur OSDs affiche 0 partout : normal, aucun disque n'a encore été donné à Ceph.
Les deux réseaux peuvent être le même, et Ceph fonctionnera. Mais la réplication passera alors dans le même tuyau que les accès disque de vos VM.
Une reconstruction après panne de disque saturera le réseau au pire moment : exactement quand les machines ont besoin de leurs données. Séparez-les dès que vous avez une seconde carte.
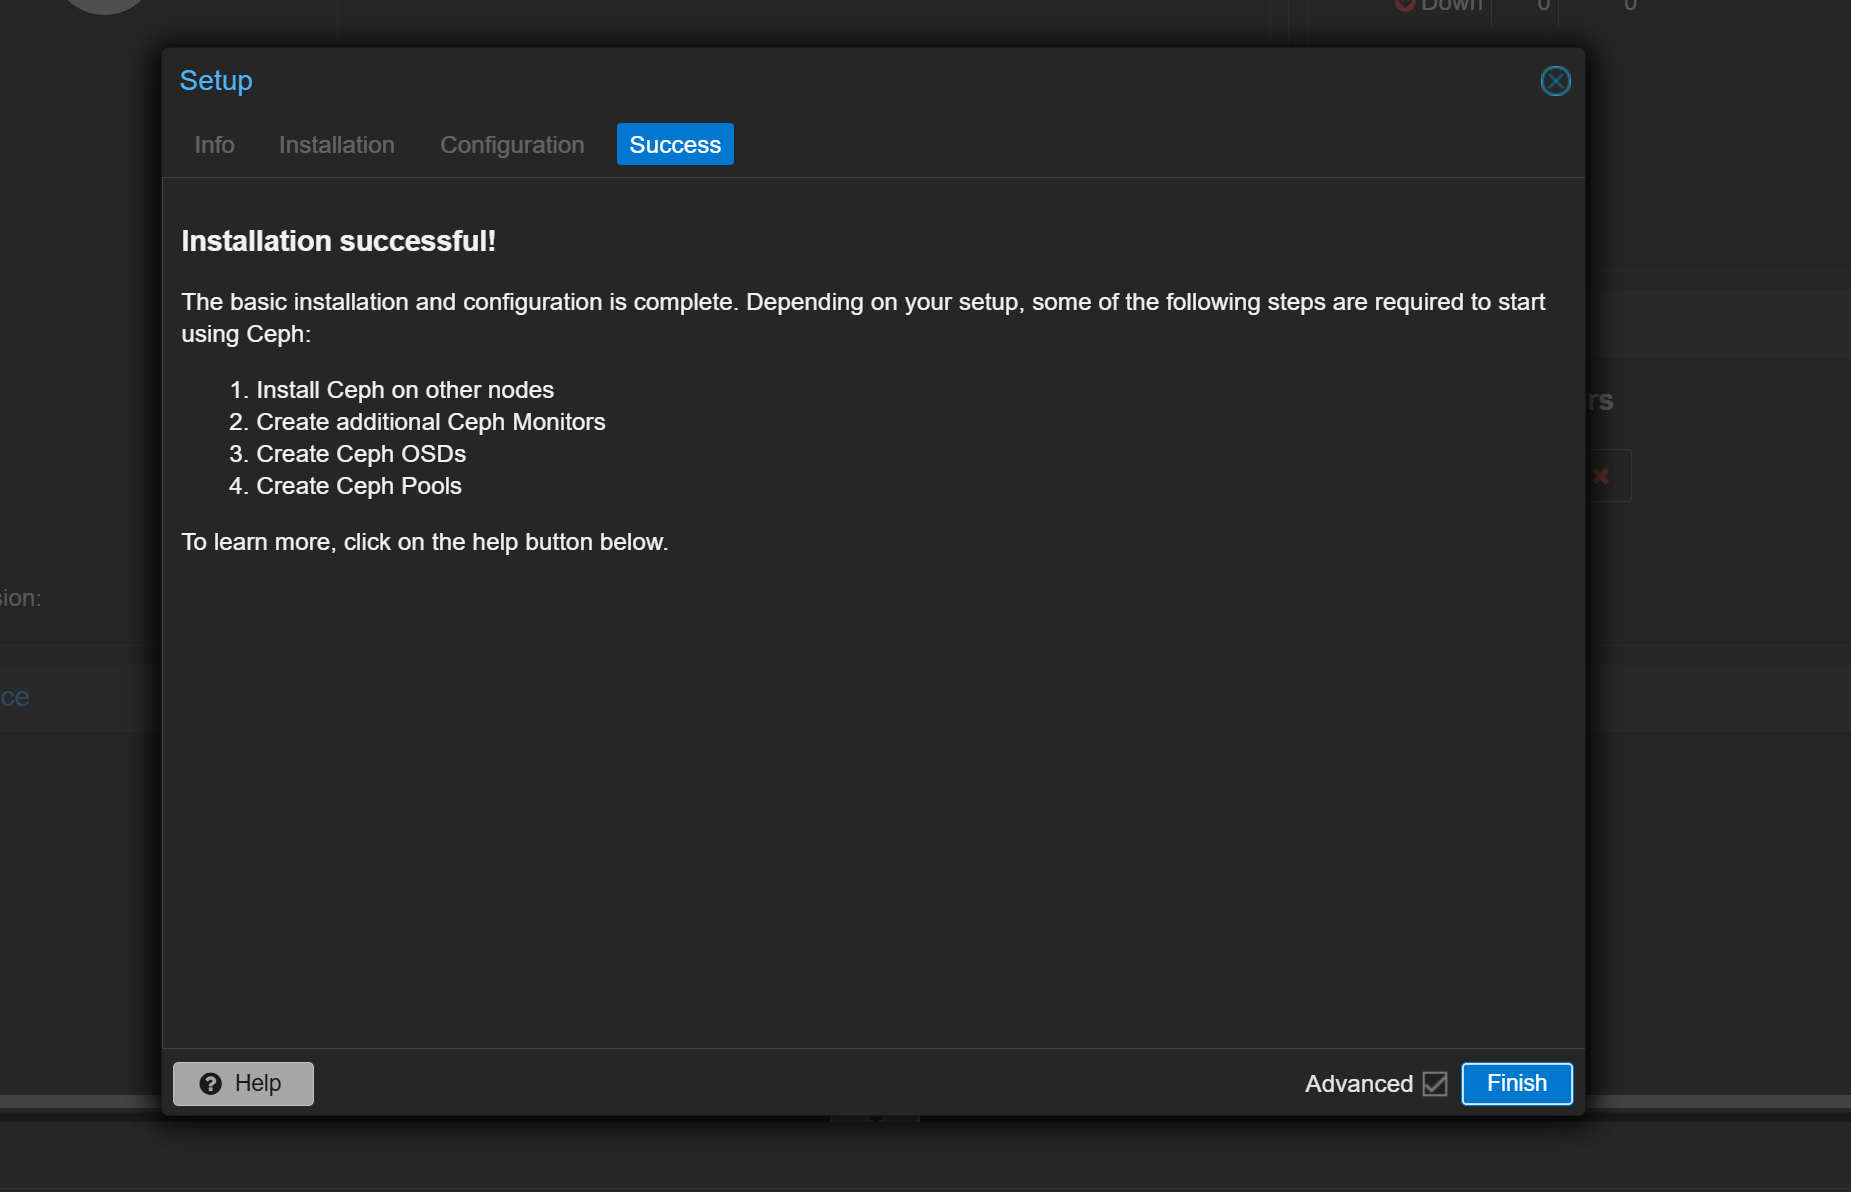
La dernière page de l'assistant : une liste, à garder en tête. L'assistant se termine en énumérant lui-même ce qu'il reste à faire : installer Ceph sur les autres nœuds, créer les moniteurs supplémentaires, créer les OSD, créer les pools.
« Installation successful » ne signifie donc pas « Ceph est prêt » : à ce stade, aucun disque n'a encore été donné au cluster et aucune donnée ne peut y être écrite. C'est exactement le programme des sections qui suivent.
Sélectionner la version Tentacle (version stable actuelle). Choisir le réseau public Ceph. Cliquer Start installation et attendre la fin.
Étape 2 — Créer le Monitor :
Nœud → Ceph → Monitor → Create (répéter sur les 3 nœuds)
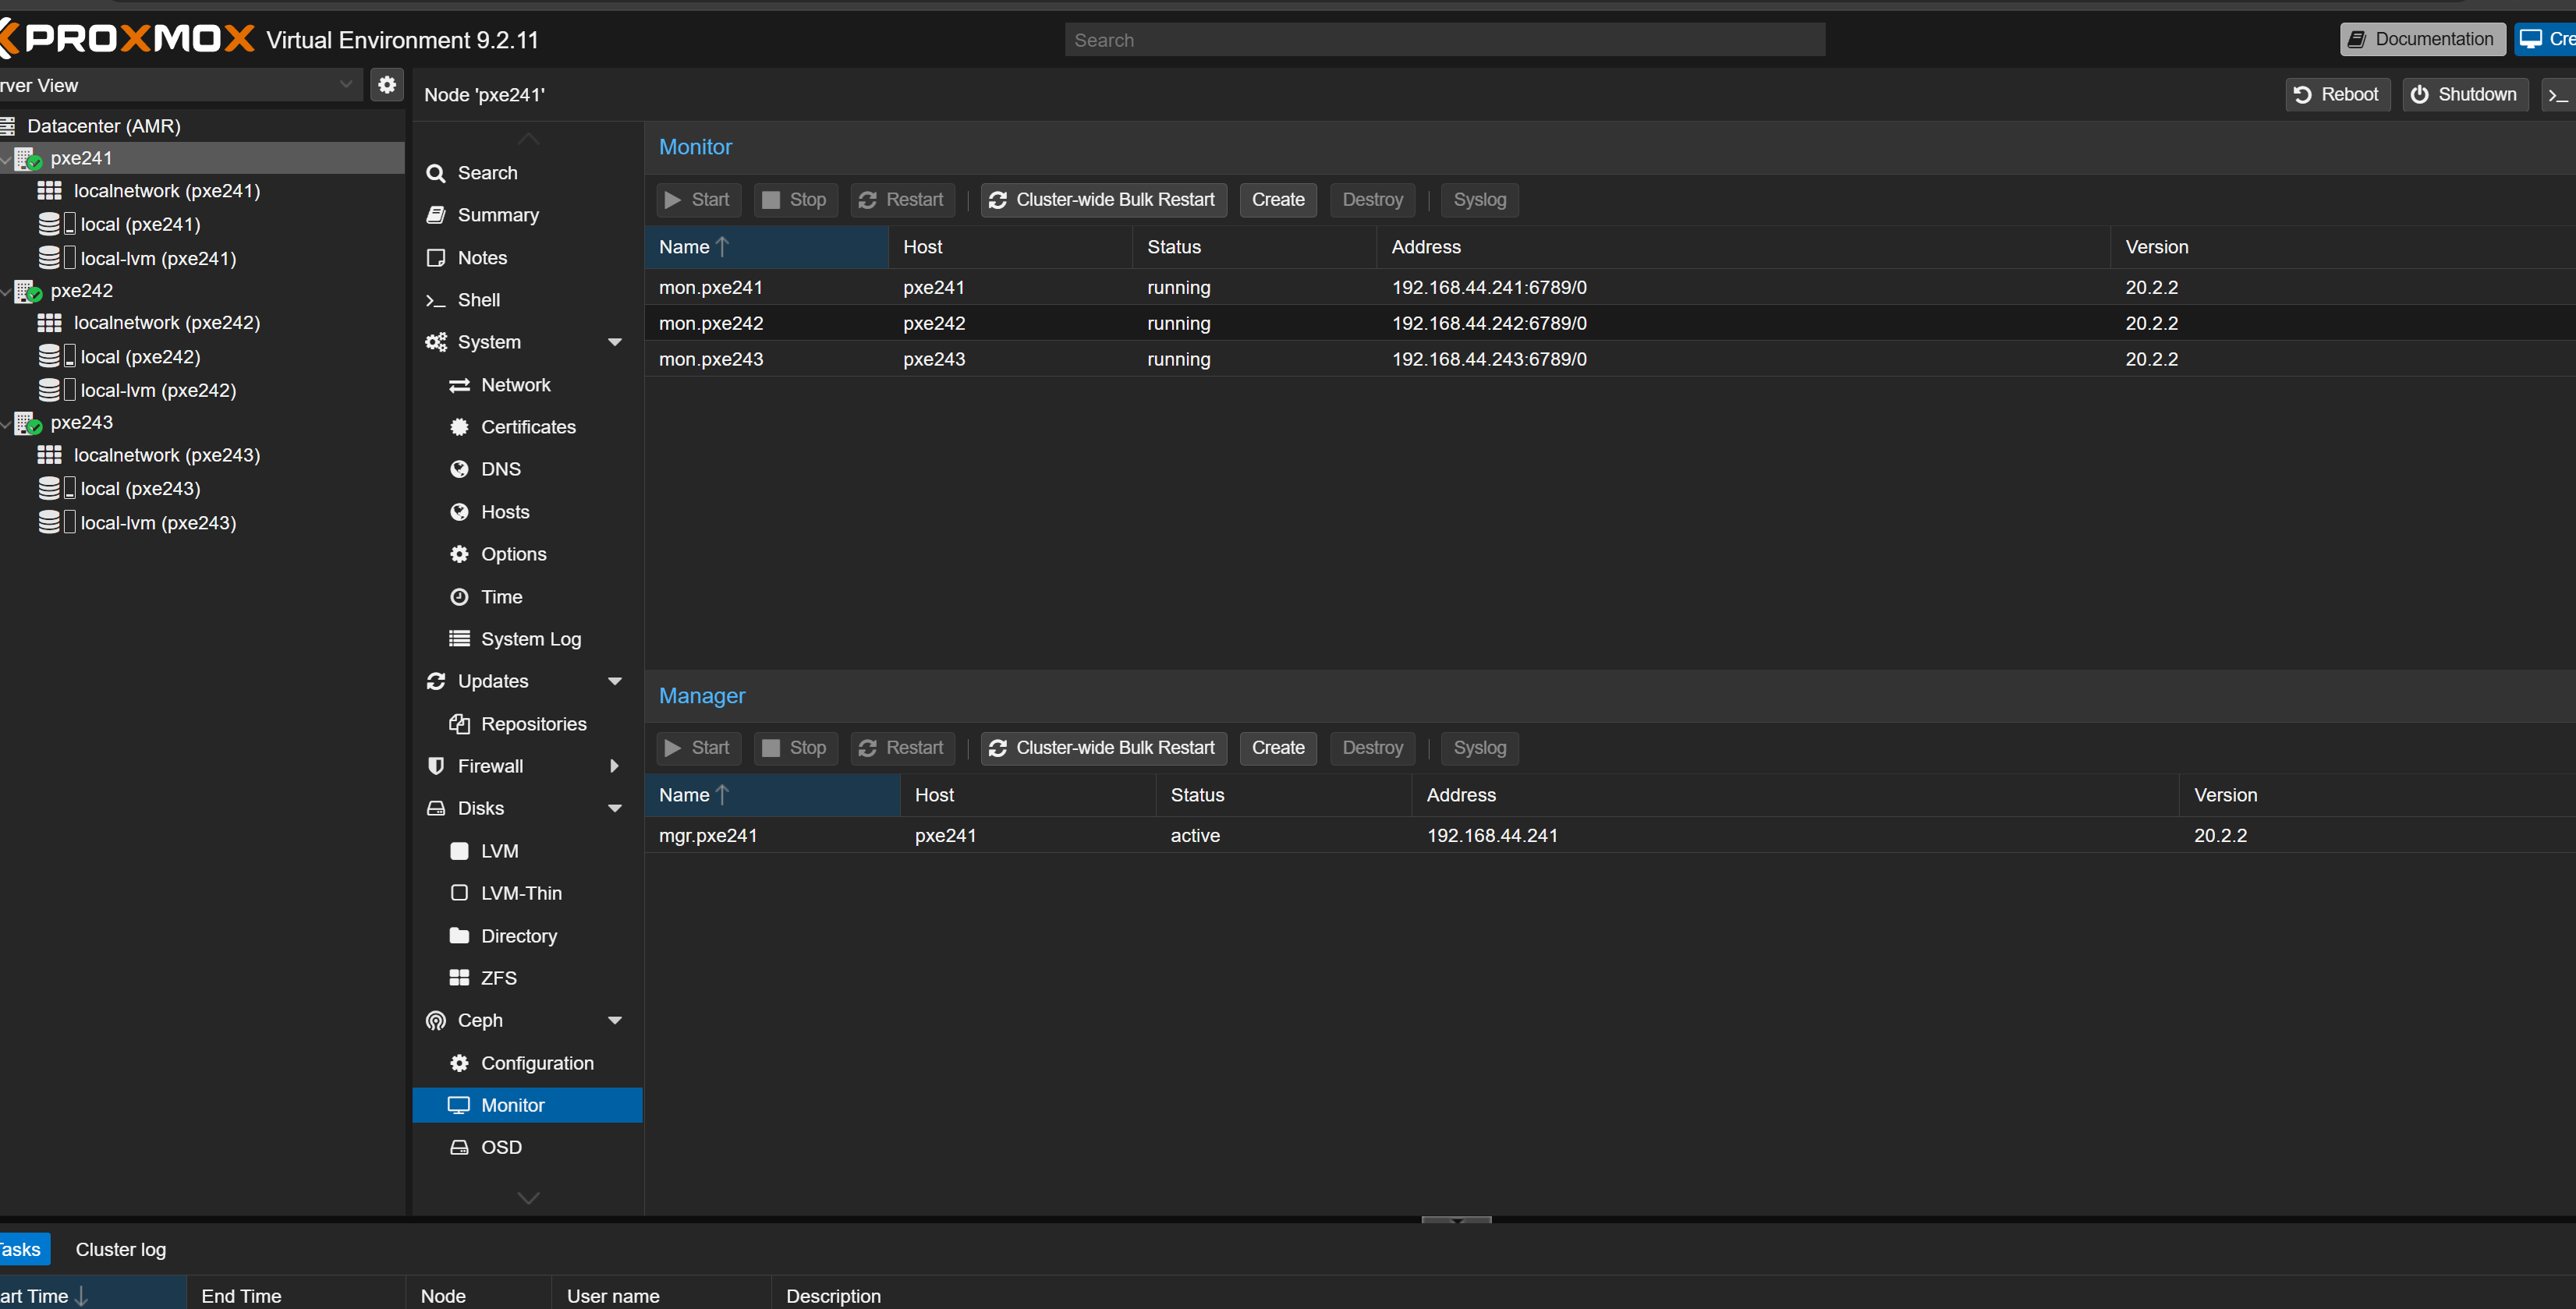
Regardez les deux tableaux ensemble. Le même écran porte les deux services, et leur état révèle tout ce qu'on vient de dire.
- En haut, Monitor : trois moniteurs,
mon.pxe211,mon.pxe212etmon.pxe213, tousrunning, un par nœud. Chacun écoute sur le port 6789, celui de Ceph, à une adresse du réseau public de Ceph (10.44.31.xsur le lab). - En bas, Manager : un seul,
mgr.pxe211, enactive. C'est celui que l'assistant a créé tout seul avec le premier moniteur.
C'est précisément la situation à corriger. Le bouton Create de la section Manager sert à ajouter les deux autres. Une fois fait, la liste affichera un manager active et deux standby — et la disparition de pxe211 ne vous privera plus ni des statistiques ni du tableau de bord.
Notez au passage le bouton Cluster-wide Bulk Restart, présent sur les deux sections : il redémarre le service sur tous les nœuds à la fois, utile après un changement de configuration.
Étape 3 — Créer le Manager :
Nœud → Ceph → Monitor, section Manager → Create (répéter sur les 3 nœuds)
Étape 4 — Créer les OSDs :
Nœud → Ceph → OSD → Create: OSD — sélectionner
/dev/sdb, laisser BlueStore (le format de stockage des OSD, proposé par défaut), cliquer Create (répéter sur les 3 nœuds)
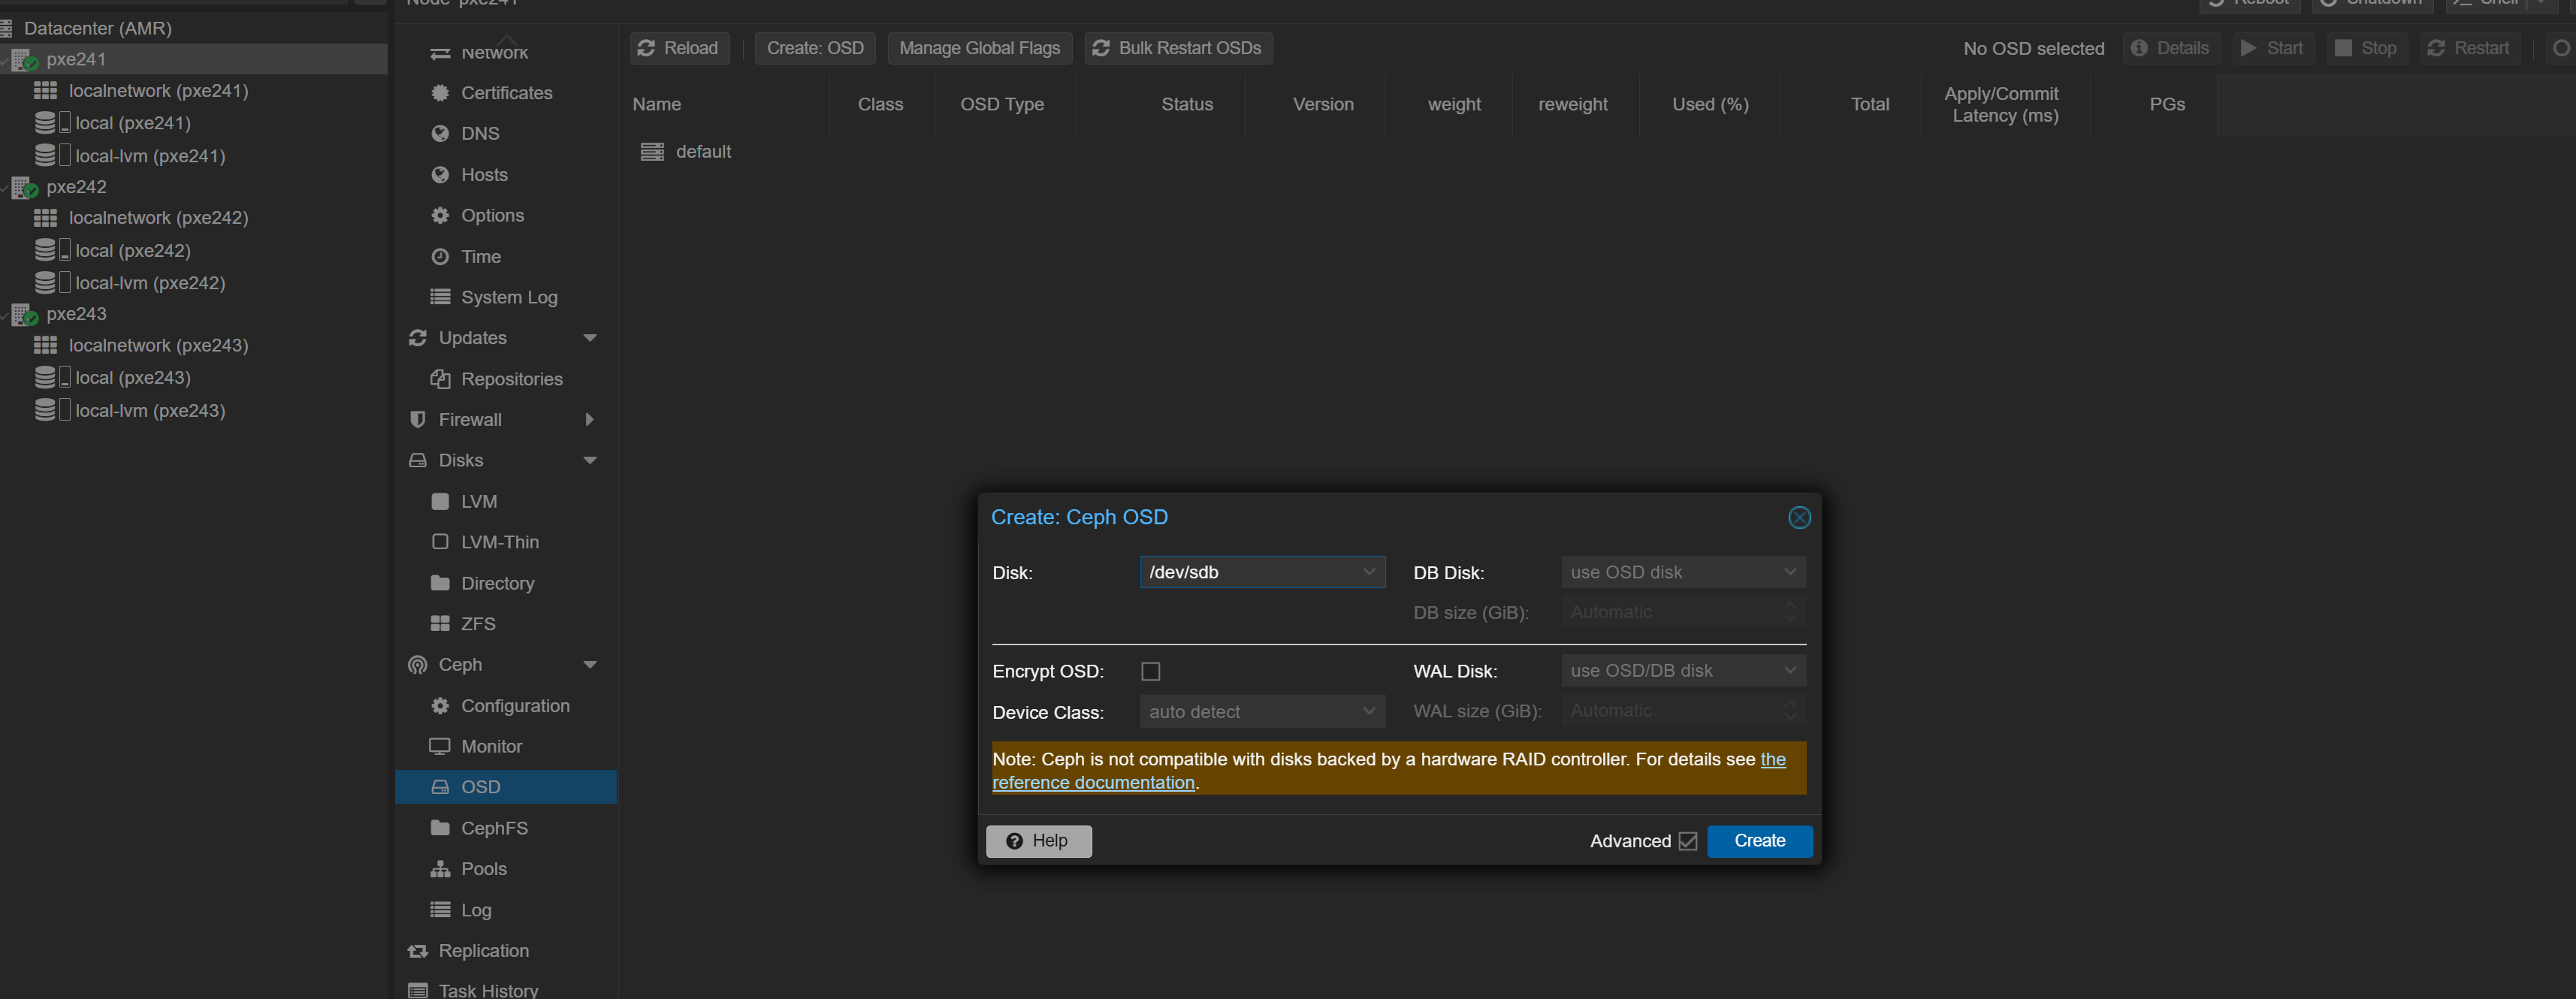
La fenêtre qui transforme un disque en OSD.
- Disk : le disque à donner à Ceph, ici
/dev/sdb. La liste ne propose que les disques entièrement vierges : si le vôtre n'apparaît pas, c'est qu'il porte encore une signature de partition, de LVM ou de ZFS. - DB Disk (database, base de métadonnées) et WAL Disk (Write-Ahead Log, journal d'écriture), laissés sur use OSD disk. Ceph peut placer sa base de métadonnées et son journal d'écriture sur un disque plus rapide que celui des données : un SSD devant des disques mécaniques, par exemple. Avec des disques identiques, on laisse tout sur le même.
- Device Class : auto detect : Ceph classe seul le disque en
hdd,ssdounvme. Cette étiquette sert à créer des règles de placement par type de matériel. - Encrypt OSD : chiffre le disque au repos. À décider maintenant — l'activer ensuite impose de détruire l'OSD et de le recréer.
L'encadré orange mérite d'être lu : Ceph n'est pas compatible avec un disque présenté par une carte RAID matérielle. Ceph veut voir le disque tel quel, pour gérer lui-même la redondance ; un RAID en dessous lui cacherait les pannes et ferait doublon avec sa propre réplication. En présence d'un contrôleur RAID, on le passe en mode IT / HBA (Initiator Target / Host Bus Adapter : le contrôleur présente les disques tels quels).
Équivalent CLI (séquence complète) :
Dans le Shell du nœud (interface web → votre nœud → Shell) :
# ===== Sur pxe211 (premier nœud) =====
# Installer les paquets Ceph (ce que fait l'onglet Installation de l'assistant).
# « yes | » répond à la question d'apt [Y/n] ; sans lui, apt abandonne.
yes | pveceph install --version tentacle --repository no-subscription

# Initialiser Ceph : --network = réseau PUBLIC (celui des clients),
# --cluster-network = réseau de RÉPLICATION entre OSD
pveceph init --network 10.<site>.<N+30>.0/24 --cluster-network 10.<site>.<N+20>.0/24

# Créer le premier Monitor sur ce nœud
pveceph mon create

# Créer le Manager
pveceph mgr create

# Créer le premier OSD avec le disque dédié Ceph
pveceph osd create /dev/sdb
Résultat attendu de pveceph osd create /dev/sdb :
create OSD on /dev/sdb (bluestore)
wiping block device /dev/sdb
200+0 records in
200+0 records out
209715200 bytes (210 MB, 200 MiB) copied, 0.52 s, 403 MB/s
Running command: /usr/bin/ceph-authtool --gen-print-key
...
--> ceph-volume lvm activate successful for osd ID: 0
--> ceph-volume lvm create successful for: /dev/sdb
La sortie, longue, se lit par ses extrémités. En tête, wiping block device : Proxmox efface le début du disque — d'où l'exigence d'un disque vierge, qu'il vérifie avant d'écrire quoi que ce soit.
À la fin, les deux lignes successful : l'OSD a reçu son numéro (osd ID: 0) et il est actif. Entre les deux, ceph-volume a fait du disque un volume LVM au format BlueStore, le format de stockage par défaut depuis Ceph Luminous.
pveceph mon create et pveceph mgr create sont plus discrets : quelques lignes de création de clés, puis le service démarre. Vérifiez l'état avec ceph status une fois tous les nœuds configurés.
Dans le Shell de chaque nœud du cluster :
# ===== Répéter sur pxe212 et pxe213 =====
pveceph mon create
pveceph mgr create   # un manager par nœud (un actif, les autres en veille)
pveceph osd create /dev/sdb   # le disque libre devient un OSD
Résultat attendu de pveceph osd create /dev/sdb sur pxe212/pxe213 :
create OSD on /dev/sdb (bluestore)
wiping block device /dev/sdb
...
--> ceph-volume lvm create successful for: /dev/sdb
Après ces commandes sur les 3 nœuds, le cluster Ceph dispose de 3 moniteurs, 3 managers et 3 OSDs — une configuration minimale redondante. Un seul OSD par nœud suffit pour un cluster d'atelier ; en production, plusieurs OSDs par nœud (un par disque physique) sont recommandés pour maximiser les performances parallèles.
Dans le Shell du nœud (interface web → votre nœud → Shell) :
# Vérifier l'état global du cluster Ceph
ceph status

# Voir l'arborescence des OSDs et leur état
ceph osd tree

# Vérifier l'utilisation de l'espace
ceph df
Résultat attendu de ceph status quand tout est en ordre :
  cluster:
    id:     a8f3b2c1-...
    health: HEALTH_OK

  services:
    mon: 3 daemons, quorum pxe211,pxe212,pxe213
    mgr: pxe211(active), standbys: pxe212, pxe213
    osd: 3 osds: 3 up, 3 in

  data:
    pools:   1 pools, 1 pgs
    objects: 0 objects, 0 B
    usage:   3.0 GiB used, 147 GiB / 150 GiB avail
Le schéma suivant montre le trajet d'une donnée dans Ceph, de gauche à droite. Un bloc, un objet ou un fichier est d'abord découpé en objets. Ces objets sont versés dans un pool.
Le pool les répartit dans ses Placement Groups : le pgid vaut simplement hash(nom de l'objet) % pg_num. Enfin, chaque PG (Placement Group) est répliqué sur plusieurs OSD, c'est-à-dire sur plusieurs disques de plusieurs serveurs. C'est cette chaîne qui explique qu'aucun disque ne détienne la totalité d'une donnée, et qu'en perdre un ne perde rien :
À retenir : Ceph répartit les données sur tous les disques du cluster, sans point de défaillance unique. Les MON tiennent la carte du cluster, les OSD gèrent chacun un disque, le MGR assure supervision et tableau de bord. On l'installe depuis Proxmox, nœud par nœud, avec de préférence un réseau de réplication séparé.