 Proxmox VE — TSSR
4. Ceph : pools, placement des données et résilience
Ceph est installé, ses moniteurs et ses OSD tournent. Il reste à en faire un stockage utilisable par les VM : un pool, et sa déclaration dans Proxmox. Puis à comprendre comment Ceph place et protège les données : l'algorithme CRUSH, le facteur de réplication et ses réseaux.
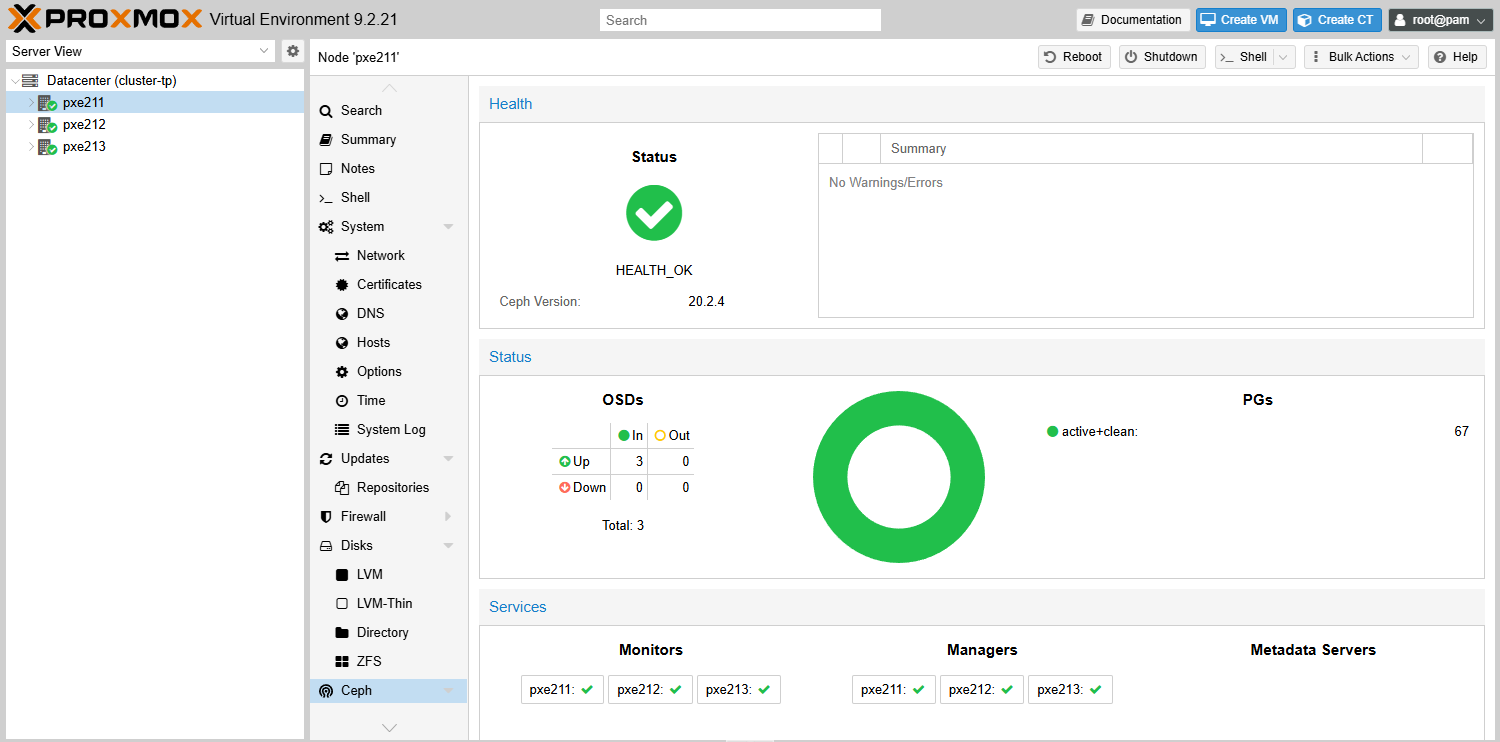
Le tableau de bord Nœud → Ceph une fois l'installation finie (cluster du lab, Ceph 20.2.4). En haut, HEALTH_OK et « No Warnings/Errors ». Au milieu, les OSD : 3 In, 3 Up, aucun Down ni Out ; et les PG, tous active+clean (l'anneau vert).
En bas, les Monitors et les Managers, un de chaque sur pxe211, pxe212 et pxe213. C'est la même information que ceph -s, présentée pour l'œil.
4.1 Créer un pool Ceph et l'intégrer à Proxmox
Un pool Ceph est un espace de stockage logique avec ses propres règles de réplication. Pour héberger des disques de VMs, on utilise le protocole RBD (Rados Block Device), qui expose des disques virtuels directement à partir du stockage objet Ceph.
Via l'interface graphique :
Nœud → Ceph → Pools → Create
| Champ | Valeur |
|---|---|
| Name | ceph-vm |
| Size (réplication) | 3 |
| Min. Size | 2 |
| PG Autoscale | on |
| Add as Storage | ✓ |
Équivalent CLI :
Dans le Shell du nœud (interface web → votre nœud → Shell) :
# Créer un pool pour les disques de VMs
# --pg_autoscale_mode on : Ceph ajuste automatiquement le nombre de placement groups
# --application rbd : indique que ce pool sera utilisé pour les disques blocs
pveceph pool create ceph-vm --pg_autoscale_mode on --application rbd

# Ajouter ce pool comme stockage dans Proxmox
pvesm add rbd ceph-vm --pool ceph-vm --content images

# Vérifier que le stockage est actif
pvesm status
Résultat attendu :
Name          Type     Status           Total
ceph-vm      rbd      active     150000000
À partir de ce moment, vous pouvez créer des VMs dont les disques sont hébergés dans Ceph. Ces disques sont accessibles depuis tous les nœuds du cluster simultanément, ce qui rend possible la migration à chaud et la haute disponibilité.
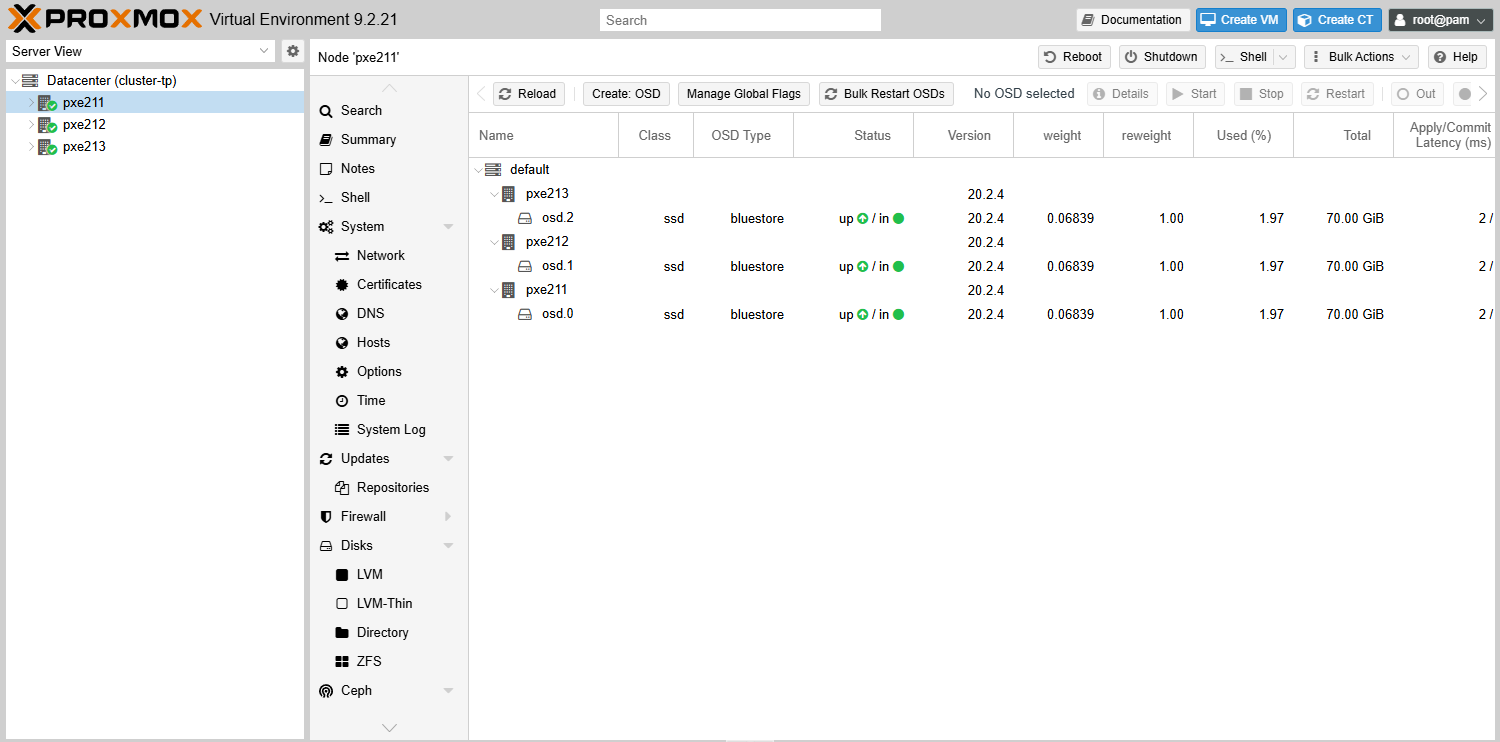
Nœud → Ceph → OSD range les OSD par nœud : osd.0 sur pxe211, osd.1 sur pxe212, osd.2 sur pxe213. Chacun est de type bluestore, marqué up et in, et dispose de 70 Gio — le disque sdb du nœud.
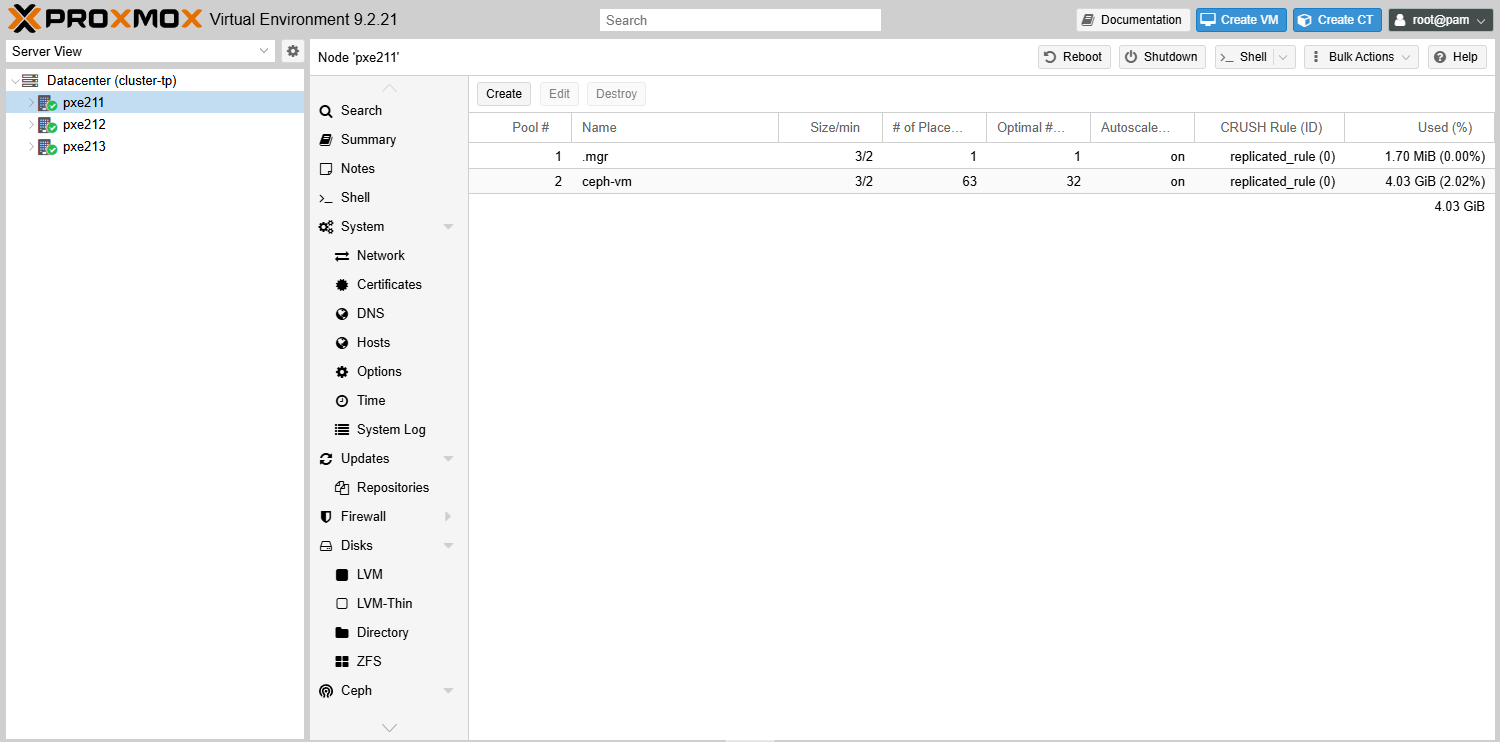
Nœud → Ceph → Pools : ceph-vm, créé ci-dessus, en 3/2 (trois copies, deux au minimum pour écrire), autoscaler on, règle replicated_rule. La ligne .mgr est un pool interne, créé par Ceph pour ses managers : on n'y touche pas.
Le pool et le stockage : deux objets différents
Créer le pool n'a fait qu'une chose : réserver un espace côté Ceph. Proxmox, lui, ne sait pas encore qu'il a le droit d'y déposer des disques.
Il lui faut pour cela un stockage de type RBD déclaré dans Datacenter → Storage, qui pointe vers ce pool. Sans cette déclaration, le pool existe et reste inutilisable : il n'apparaît nulle part au moment de créer un disque.
La case Add as Storage fait ce travail pour vous — comme l'option --add_storages en ligne de commande. Vérifiez-le :
Dans le Shell du nœud (interface web → votre nœud → Shell) :
pvesm status | grep rbd   # le stockage RBD doit être actif
grep -A 5 "^rbd:" /etc/pve/storage.cfg   # sa déclaration dans la configuration des stockages
Résultat attendu : une section rbd: ceph-vm avec la ligne pool ceph-vm. C'est elle, le stockage ; le pool est ce qu'elle désigne.
Quand faut-il le déclarer à la main ? Trois situations, et vous rencontrerez la dernière en entreprise :
- la case a été décochée, ou le pool a été créé sans
--add_storages; - vous voulez un autre identifiant, d'autres types de contenu, ou restreindre le stockage à certains nœuds ;
- le cluster Ceph est externe, hébergé ailleurs que sur vos nœuds. Dans ce cas il n'y a aucun pool à créer dans l'interface — on déclare seulement le stockage RBD, avec l'adresse des moniteurs et la clé d'accès.
Dans l'interface : Datacenter → Storage → Add → RBD.
| Champ | Valeur | Ce que ça fait |
|---|---|---|
| ID | ceph-vm |
Le nom du stockage dans Proxmox |
| Pool | ceph-vm |
Le pool Ceph visé |
| Monitor(s) | (laisser vide) | Vide = le cluster Ceph local ; à renseigner pour un Ceph externe |
| User name | admin |
L'utilisateur Ceph, admin en hyperconvergé |
| Content | Disk image, Container |
Ce qu'on autorise à y ranger |
| Nodes | (tous) | Ceph étant partagé, laissez les trois |
Dans le Shell du nœud (interface web → votre nœud → Shell) :
# Equivalent en ligne de commande
pvesm add rbd ceph-vm --pool ceph-vm --content images,rootdir
pvesm status   # vérifier qu'il est actif
Résultat attendu :
root@pxe211:~# pvesm add rbd ceph-vm --pool ceph-vm --content images,rootdir
root@pxe211:~# pvesm status
Name             Type     Status           Total            Used       Available        %
ceph-vm           rbd     active       314572800        18874368       295698432    6.00%
local             dir     active        98559220        22417684        71095996   22.75%
local-lvm     lvmthin     active       167772160        39267532       128504628   23.40%
Le stockage RBD apparaît sur tous les nœuds du cluster à la fois, sans qu'il faille répéter la commande ailleurs : la déclaration vit dans /etc/pve/storage.cfg, répliqué par pmxcfs.
La capacité annoncée est l'espace utile, après réplication. Avec le facteur 3 par défaut de Ceph, 300 Gio disponibles correspondent à 900 Gio de disques bruts. C'est le coût de la redondance, et il surprend souvent au premier calcul de dimensionnement.
--content images,rootdir limite ce pool aux disques de VM et de conteneurs. Un pool RBD ne peut pas héberger d'ISO ni de sauvegardes : ce sont des fichiers, et RBD expose des périphériques de bloc. Pour des fichiers sur Ceph, il faut CephFS, déclaré séparément.
Erreur fréquente : Dans un atelier avec du nested virtualization, les performances Ceph seront faibles car les disques sdb sont eux-mêmes des disques virtuels. Les erreurs de latence élevée (slow ops) sont normales dans ce contexte et ne doivent pas alarmer. En production, Ceph s'utilise sur des disques physiques dédiés, idéalement des SSDs NVMe pour les journaux.
4.2 CRUSH, l'algorithme de placement
Ceph n'a pas de serveur de métadonnées central : chaque client calcule lui-même où sont ses données, avec l'algorithme CRUSH (Controlled Replication Under Scalable Hashing). CRUSH s'appuie sur une carte de la topologie physique, la CRUSH map : centre de données, baies, hôtes, OSD.
Quand un pool a size=3, CRUSH place les trois répliques sur trois hôtes différents ; une règle de baie les placerait sur des baies différentes. ceph osd tree affiche cette hiérarchie.
4.3 Facteur de réplication et dimensionnement du cluster Ceph
Par défaut, Ceph crée les pools avec size=3 (3 répliques) et min_size=2 (minimum pour accepter les écritures). Chaque objet est stocké en 3 exemplaires, tolérant la perte simultanée d'un OSD.
Impact sur l'espace utile : avec size=3, seul 1/3 de l'espace brut est utilisable. 3 nœuds × 500 Go = 1500 Go bruts → 500 Go utiles. C'est le coût de la résilience.
Dans le Shell du nœud (interface web → votre nœud → Shell) :
# Vérifier le facteur de réplication d'un pool
ceph osd pool get ceph-vm size
# → size: 3

ceph osd pool get ceph-vm min_size
# → min_size: 2

# Voir la capacité totale (RAW vs AVAIL)
ceph df
Résultat attendu de ceph df :
--- RAW STORAGE ---
CLASS  SIZE     AVAIL    USED     RAW USED  %RAW USED
hdd    150 GiB  147 GiB  3.0 GiB   3.0 GiB       2.00
TOTAL  150 GiB  147 GiB  3.0 GiB   3.0 GiB       2.00
Pour calculer l'espace utile : (150 GiB bruts) / 3 (réplication) × 80% (marge opérationnelle) = 40 GiB utilisables. Les 20% de marge absorbent les rééquilibrages lors des opérations de maintenance.
Règle de dimensionnement : ne jamais remplir un cluster Ceph au-delà de 80% de son espace utile. Les seuils de Ceph sont ensuite rapides : à 85 % d'un OSD (nearfull), le cluster passe en HEALTH_WARN ; à 95 % (full), il bloque toutes les écritures pour protéger l'intégrité des données.
Et la marge de 20 % n'est pas du confort : quand un nœud tombe, ses données sont reconstruites sur les OSD restants, qui doivent avoir la place de les recevoir.
4.4 Réseau public et réseau cluster
En production, Ceph sépare deux trafics. Le réseau public relie les clients (VM, Proxmox) et les OSD ; le réseau cluster relie les OSD entre eux, pour la réplication et la recopie après une panne. Les séparer protège les performances des VM pendant une recopie massive.
Les deux se fixent à l'initialisation de Ceph (--network et --cluster-network), et se lisent dans Nœud → Ceph → Configuration.
À retenir : un pool RBD porte les disques de VM et de conteneurs (pas d'ISO ni de sauvegardes). CRUSH calcule l'emplacement des données sans serveur de métadonnées.
size=3 / min_size=2 : trois copies, écritures acceptées tant que deux restent ; un tiers de l'espace brut est utile, et on ne dépasse pas 80 %. Les réseaux Ceph se fixent dès l'initialisation.