 Proxmox VE — TSSR
4. ZFS — le système de fichiers qui se souvient de tout — Créer et gérer un pool ZFS
4.3 Créer et gérer un pool ZFS
La gestion ZFS repose sur deux commandes distinctes : zpool pour le pool (les disques, la redondance, la santé) et zfs pour les datasets (les volumes logiques, leurs propriétés, les snapshots).
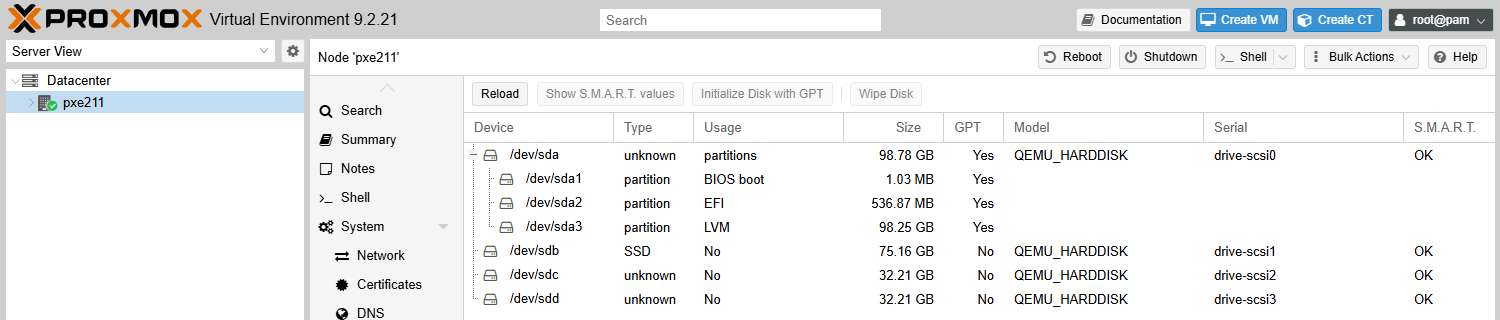
Avant de créer un pool, on identifie les disques. Nœud → Disks liste chaque disque avec son usage actuel. Sur pxe211 (Proxmox VE 9.2.21), avant le pool ZFS.
/dev/sda porte le système (partitions BIOS boot, EFI, LVM). /dev/sdb, /dev/sdc et /dev/sdd affichent No dans la colonne Usage : ils sont libres. sdc et sdd font la même taille, 32,21 Go : ce sont eux qui recevront le miroir ZFS.
L'interface ne propose un disque à ZFS que si sa colonne Usage indique No ; sinon, il faut d'abord l'effacer (Wipe Disk), après avoir vérifié trois fois son nom. Dans le lab, les disques de ZFS sont sdc et sdd ; sdb est réservé à Ceph.
Depuis l'interface graphique : Nœud → Disks → ZFS → Create: ZFS
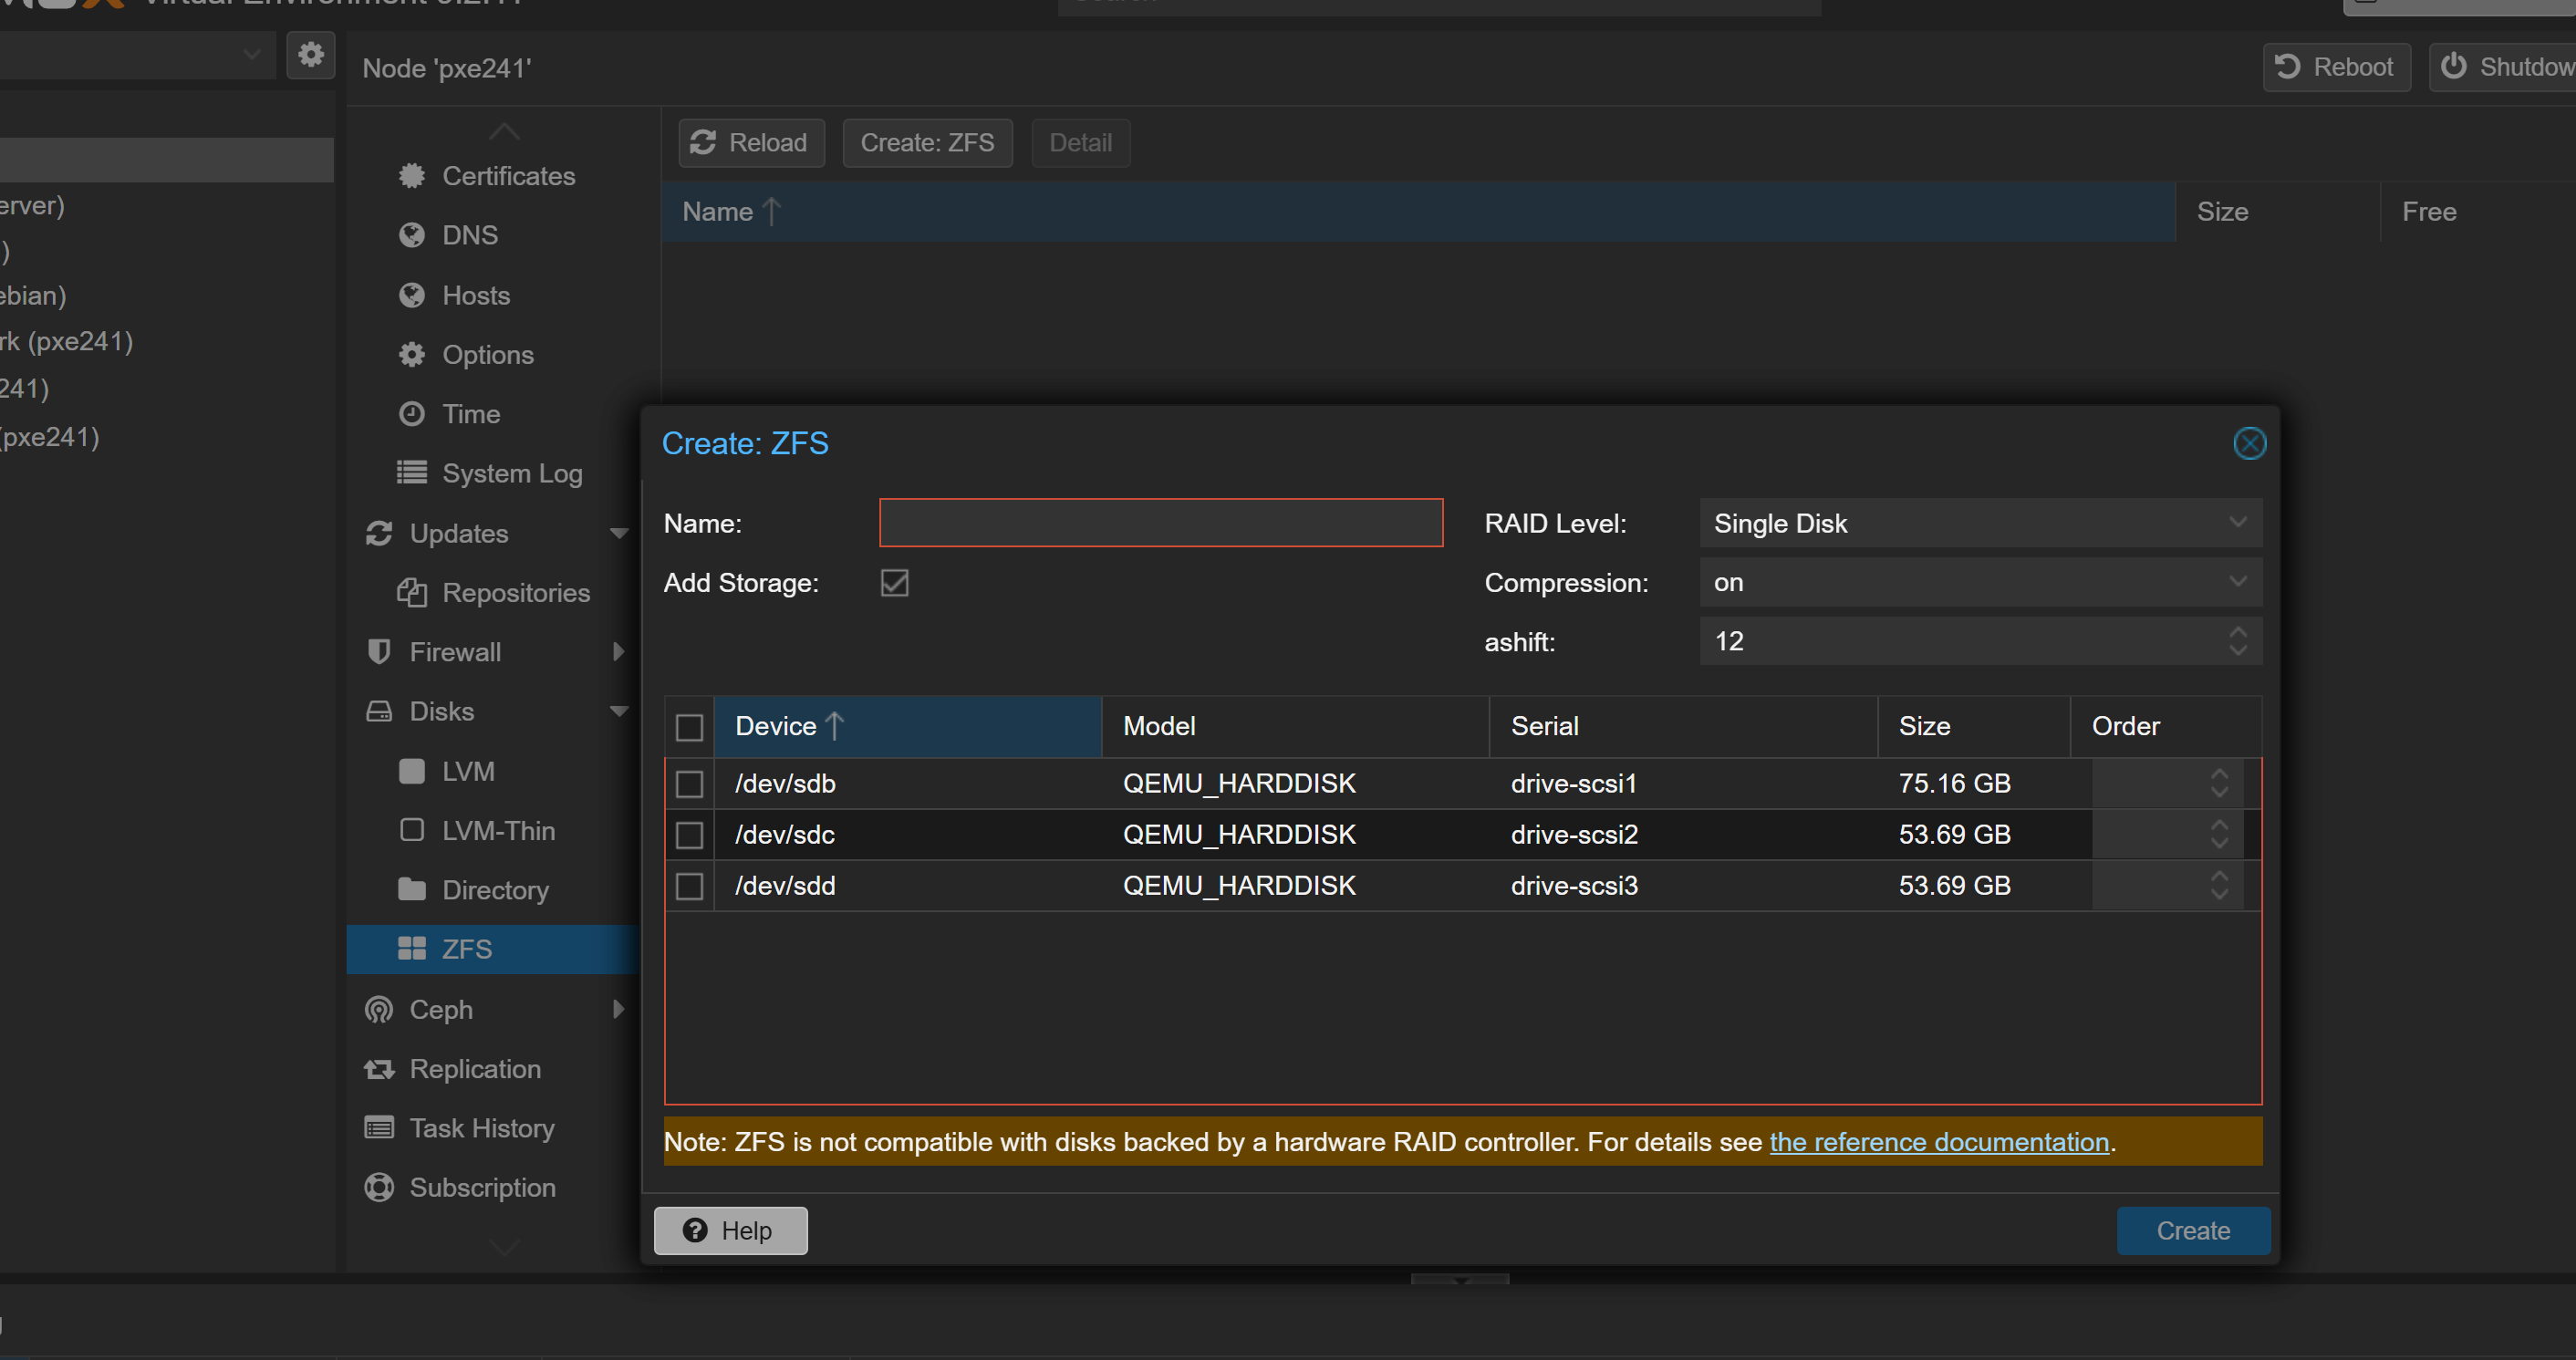
Trois points à relever dans cette fenêtre.
-
La liste des disques.
sdcetsddfont exactement la même taille : 32,21 Go sur le lab d'exemple,pxe211.sdben fait 75,16 (les tailles peuvent différer sur votre nœud).C'est la raison technique du plan de disques : dans un miroir, la capacité du pool est celle du plus petit disque. Associer
sdbàsdcdonnerait 32,21 Go utiles et gaspillerait près de 43 Go.sdbreste par ailleurs réservé à Ceph. -
Le champ RAID Level affiche
Single Diskpar défaut : aucune redondance. C'est celui qu'il faut basculer surMirror. - La case Add Storage, cochée, déclare automatiquement le pool comme stockage Proxmox. Sans elle, le pool existerait côté système sans apparaître dans l'interface, et il faudrait l'ajouter avec
pvesm add.
L'avertissement orange rappelle une règle absolue : ZFS ne se pose jamais sur un contrôleur RAID matériel. Il a besoin d'un accès direct aux disques pour vérifier les sommes de contrôle et réparer les blocs — un contrôleur RAID s'interposerait et lui masquerait l'état réel du support.
| Champ | Valeur |
|---|---|
| Name | datapool |
| RAID Level | Mirror |
| Disk 1 | /dev/sdc |
| Disk 2 | /dev/sdd |
En CLI :
Dans le Shell du nœud (interface web → votre nœud → Shell) :
# Créer un pool mirror nommé "datapool" sur deux disques
# (l'interface ajoute d'office -o ashift=12 : blocs de 4 Kio, adaptés aux disques actuels)
zpool create -o ashift=12 datapool mirror /dev/sdc /dev/sdd

# Vérifier l'état et la santé du pool
zpool status

# Créer un dataset (sous-volume avec ses propres propriétés)
zfs create datapool/vms

# Activer la compression transparente lz4 (rapide, bon ratio)
zfs set compression=lz4 datapool

# Vérifier la liste des datasets et leur occupation
zfs list
Résultat attendu de zpool status :
  pool: datapool
 state: ONLINE
config:
        NAME        STATE     READ WRITE CKSUM
        datapool    ONLINE       0     0     0
          mirror-0  ONLINE       0     0     0
            sdc     ONLINE       0     0     0
            sdd     ONLINE       0     0     0

errors: No known data errors
Les trois colonnes de droite sont les compteurs qu'on surveille. READ et WRITE comptent les erreurs d'entrée-sortie remontées par le disque.
CKSUM compte les blocs dont la somme de contrôle ne correspondait pas : des corruptions silencieuses, que le miroir a réparées. Tant qu'ils restent à zéro et que chaque ligne est ONLINE, le pool est sain.
Erreur fréquente : ne jamais utiliser un disque qui contient déjà des partitions ou des données sans l'avoir effacé avec wipefs -a /dev/sdX. ZFS refusera de créer le pool si le disque contient une signature de système de fichiers reconnu.
Les propriétés qui comptent
Une propriété se pose sur un dataset avec zfs set, se lit avec zfs get, et s'hérite par les datasets enfants.
| Propriété | Exemple | Effet |
|---|---|---|
| Compression | zfs set compression=lz4 datapool/vms |
lz4 : usage général, très rapide. zstd : meilleur taux, CPU modéré. gzip : archivage, CPU élevé |
| Quota | zfs set quota=50G datapool/utilisateurs |
Plafond : le dataset ne dépassera pas 50 Go |
| Réservation | zfs set reservation=10G datapool/service |
Garantie : 10 Go restent toujours disponibles pour ce dataset |
| Déduplication | dedup=on |
Ne stocke qu'une fois les blocs identiques. Très gourmande en RAM (sa table, la DDT — DeDuplication Table —, doit tenir en mémoire) : déconseillée en production, sauf cas très particulier |
Le provisionnement fin est natif. Un zvol déclaré « fin » (-s, pour sparse) n'occupe que les blocs réellement écrits. Sans -s, ZFS lui réserve d'emblée toute sa taille, par la propriété refreservation : c'est le provisionnement épais.
Dans le Shell du nœud (interface web → votre nœud → Shell) :
zfs create -V 200M essai/zvol-epais        # épais : taille réservée d'emblée
zfs create -s -V 200M essai/zvol-fin       # fin : rien n'est réservé
zfs get -o name,property,value refreservation,volsize essai/zvol-epais essai/zvol-fin   # réservation et taille
zfs list -o name,used,refer essai          # l'espace réellement compté
Résultat attendu (nœud pxe212, sur un pool d'essai essai monté sur des fichiers, supprimé ensuite) :
NAME              PROPERTY        VALUE
essai/zvol-epais  refreservation  205M
essai/zvol-epais  volsize         200M
essai/zvol-fin    refreservation  none
essai/zvol-fin    volsize         200M
NAME    USED  REFER
essai   205M  30.6K
Le zvol épais réserve 205 Mo (ses 200 Mo, plus les métadonnées), comptés dans USED alors que rien n'est écrit. Le zvol fin ne réserve rien : refreservation none.
Le provisionnement fin permet de promettre plus d'espace qu'on n'en a. Si toutes les VM écrivent en même temps jusqu'à leur taille, le pool sature : erreurs d'écriture, VM en erreur. On surveille donc l'occupation réelle (zpool list, colonne CAP) et on pose une alerte vers 75 à 80 %.
4.4 Snapshots ZFS
ZFS intègre les snapshots directement au niveau du système de fichiers, sans passer par LVM comme sur un système classique. Cette intégration change tout, pour une raison technique : ZFS est copy-on-write.
Concrètement, ZFS n'écrase jamais un bloc en place — il écrit la modification ailleurs et met à jour ses pointeurs. Un snapshot n'a donc rien à copier : il se contente de figer les pointeurs actuels.
C'est pourquoi il est instantané et sans coût initial, quelle que soit la taille du dataset. Un snapshot d'un pool de 2 To se prend en une fraction de seconde et n'occupe zéro octet à l'instant où on le crée.
L'espace ne se consomme qu'ensuite, au fur et à mesure que les données divergent. Chaque bloc modifié après le snapshot est conservé en double : l'ancien pour le snapshot, le nouveau pour l'état courant. Un snapshot sur un système qui écrit beaucoup grossit donc vite — d'où l'intérêt de ne pas les accumuler.
Avec plusieurs snapshots, l'espace se partage. Un bloc ancien reste tant qu'un snapshot au moins le désigne. Supprimer le plus ancien ne libère donc pas forcément de place, si le suivant référence les mêmes blocs.
Pour savoir qui occupe quoi : zfs list -t all -o name,used,refer,written,clones. USED est ce que la suppression libérerait ; WRITTEN, ce qui a été écrit depuis le snapshot précédent ; CLONES, les clones qui en dépendent.
Deux points de vigilance qui distinguent ZFS de l'instantané LVM :
zfs rollback est destructif et unidirectionnel. Revenir à un snapshot détruit tout ce qui a été écrit depuis, sans confirmation au-delà de l'option. Et il faut revenir dans l'ordre : ZFS refuse de sauter par-dessus un snapshot plus récent sans le -r qui le détruit au passage.
Un snapshot n'est pas une sauvegarde tant qu'il reste dans le pool. Il partage le sort du pool : si le disque meurt, le snapshot meurt avec. C'est zfs send qui le transforme en sauvegarde réelle, en l'expédiant vers un autre pool ou une autre machine — la contrepartie ZFS de l'envoi vers PBS.
Dans le Shell du nœud (interface web → votre nœud → Shell) :
# Créer un snapshot (syntaxe : dataset@nom-du-snapshot)
zfs snapshot datapool/vms@avant-migration

# Lister tous les snapshots
zfs list -t snapshot

# Revenir à l'état du snapshot (le dataset actuel est écrasé)
zfs rollback datapool/vms@avant-migration

# Supprimer un snapshot devenu inutile
zfs destroy datapool/vms@avant-migration
Résultat attendu de zfs list -t snapshot :
NAME                            USED  AVAIL     REFER  MOUNTPOINT
datapool/vms@avant-migration      0B      -     24.5K  -
La colonne USED à 0B signifie qu'aucun bloc n'a encore changé depuis le snapshot — c'est la conséquence directe du Copy-on-Write vu plus haut.
4.5 Intégrer ZFS dans Proxmox VE
Une fois le pool créé, il faut l'enregistrer auprès de Proxmox pour qu'il apparaisse comme source de stockage dans l'interface.
Via l'interface graphique : Datacenter → Storage → Add → ZFS
| Champ | Valeur |
|---|---|
| ID | zfs-vms |
| ZFS Pool | datapool/vms |
| Content | Disk image, Container |
En CLI :
Dans le Shell du nœud (interface web → votre nœud → Shell) :
# Déclarer le dataset datapool/vms comme stockage Proxmox
# --content images,rootdir : autorise les disques de VMs et les rootfs LXC
pvesm add zfspool zfs-vms --pool datapool/vms --content images,rootdir

# Vérifier que le stockage est bien enregistré
pvesm status
Résultat attendu (nœud pxe211, disques de 30 Go) :
Name             Type     Status     Total (KiB)      Used (KiB) Available (KiB)        %
zfs-vms       zfspool     active        29965928              96        29965832    0.00%
Si vous avez laissé Add Storage coché à la création du pool (§4.3), un stockage datapool existe déjà et pointe sur la racine du pool. Celui-ci, zfs-vms, pointe sur le dataset vms : on peut ainsi lui donner ses propres propriétés (quota, compression).
Depuis ce moment, zfs-vms est sélectionnable lors de la création d'une VM ou d'un conteneur. Le disque sera stocké directement dans le pool ZFS avec tous les avantages qui en découlent : compression automatique, snapshots intégrés à l'interface Proxmox, vérification d'intégrité continue.
Bonnes pratiques à retenir : ne jamais mélanger ZFS avec LVM sur les mêmes disques. ZFS consomme de la RAM : la documentation de Proxmox demande « au moins 8 Go pour commencer », et davantage dès que le budget le permet (§4.6).
Et ne placez jamais ZFS derrière un contrôleur RAID dont le cache d'écriture n'est pas protégé par batterie. ZFS croirait ses écritures en sécurité, alors qu'elles dorment dans une mémoire que la moindre coupure efface.
Déplacer un disque existant vers ZFS. Une VM déjà installée sur local-lvm peut passer sur le stockage ZFS sans être arrêtée.
Dans l'interface : VM → Hardware → le disque → Disk Action → Move Storage, cible zfs-vms, case Delete source cochée. En ligne de commande : qm disk move <vmid> scsi0 zfs-vms --delete 1.
QEMU copie le disque pendant que la VM tourne, en répercutant ses écritures sur la copie, puis bascule sur la copie. Sans Delete source, l'ancien volume reste attaché à la VM en unused0 et continue d'occuper local-lvm. Le format suit le stockage cible : ZFS n'accepte que raw.
4.6 L'ARC — le cache mémoire qui accélère ZFS
ZFS consomme de la RAM : c'est son ARC (Adaptive Replacement Cache), un cache de lecture tenu en mémoire vive, qui garde les blocs récemment ou fréquemment lus. Il équilibre seul les deux, et s'adapte aux habitudes de lecture.
Sur un nœud qui héberge aussi des VM, l'ARC entre en concurrence avec elles pour la mémoire. Depuis Proxmox VE 8.1, l'installateur pose donc une limite prudente : 10 % de la RAM, 16 Gio au plus, écrite dans /etc/modprobe.d/zfs.conf (options zfs zfs_arc_max=…).
Un nœud installé avant la 8.1 n'a pas cette limite. arc_summary affiche le plafond (Max target size) et la mémoire réellement occupée (Current size).